抽取阶段处理的是句子层面的错:边界错、类型错、关系方向反了。融合阶段的问题换了性质。这时你手上有两三份「都对」的数据:自己爬的百科、合作方给的库、历史遗留的 CSV。各自的准确率都不低,拼在一起却变成一坨。
这就是知识融合(Knowledge Fusion / Integration)要处理的事。它的输入输出很明确:输入是多个知识图谱(或同一图谱的多个来源、多个版本),输出是核心知识层,即重复的合并、冲突的记住、等价的连起来之后的那一层。融合既发生在模式(schema)层,也发生在实例(instance)层,位置是「知识加工」的第三步,前一步是抽取,后两步是推理和链接发现。
一、为什么「抽完」和「融合完」是两个世界
需要融合的典型情况有六条,可以对照自己的库看中了几条。
| 情况 | 具体表现 |
|---|---|
| 术语不一致 | 同一概念不同名,或同名指不同东西 |
| 同义关系缺失 | 你知道 A 公司就是 B 公司,但图谱里没这条路,查不过去 |
| 数据重复 | 同一家医院三条记录,每条缺一点字段 |
| 格式与单位不统一 | 「北京市朝阳区」与「朝阳区, 北京」,「1.2 亿」与「120000000」 |
| 同一属性多个冲突取值 | 注册资本三个库填三个数,谁也没标来源 |
| 语言与粒度不一致 | 中文库的「苹果公司」与英文库的 Apple Inc.,有的库把「苹果」当物种 |
这些在抽取阶段是看不见的,因为抽取只对单条文本负责。融合阶段才第一次出现全局一致性约束:一个实体在图里只能有一个身份,一个属性在某个时点上只能有一个权威值。
由此可以推出一条工程结论:融合很难做成「跑一遍就完事」的离线任务。上游每新增一个数据源,等价关系和冲突判断都会被推翻重算一部分,因此工业界更常见的做法是把它做成持续运行的去重服务。
二、名字很乱:先统一术语
这一节必须先澄清,因为它直接决定论文看得对不对、方案选得对不对。围绕「到底在匹配什么」有一堆近义词。
| 术语 | 英文 | 匹配范围 |
|---|---|---|
| 实例匹配、实体匹配 | Instance / Entity Matching | 在两个知识图谱的实例之间建立对应 |
| 实体消解、共指消解 | Entity Resolution / Coreference | 在同一图谱内部识别指向同一实体的多条记录 |
| 记录链接 | Record Linkage | 落在数据库记录层面 |
| 重复检测 | Duplicate Detection | 找出指向同一对象的重复记录 |
| 人名消歧 | Name Disambiguation | 人名场景下的重复检测 |
四个名词也需要讲透。实例(Instance)是知识图谱实例层的对象;实体(Entity)是语义层面的真实世界对象;记录(Record)是数据库里的一行;对象(Object)是知识图谱里的对象。
这几句区分的关键在于一个结论:实体在现实中唯一,但 Web 上的数据来自不同来源、不同时间,同一个实体因而会有多条记录、多个取值,甚至互相矛盾,而记录本身是「本地」的、被特定上下文约束的。融合的对象是记录,目标是实体。
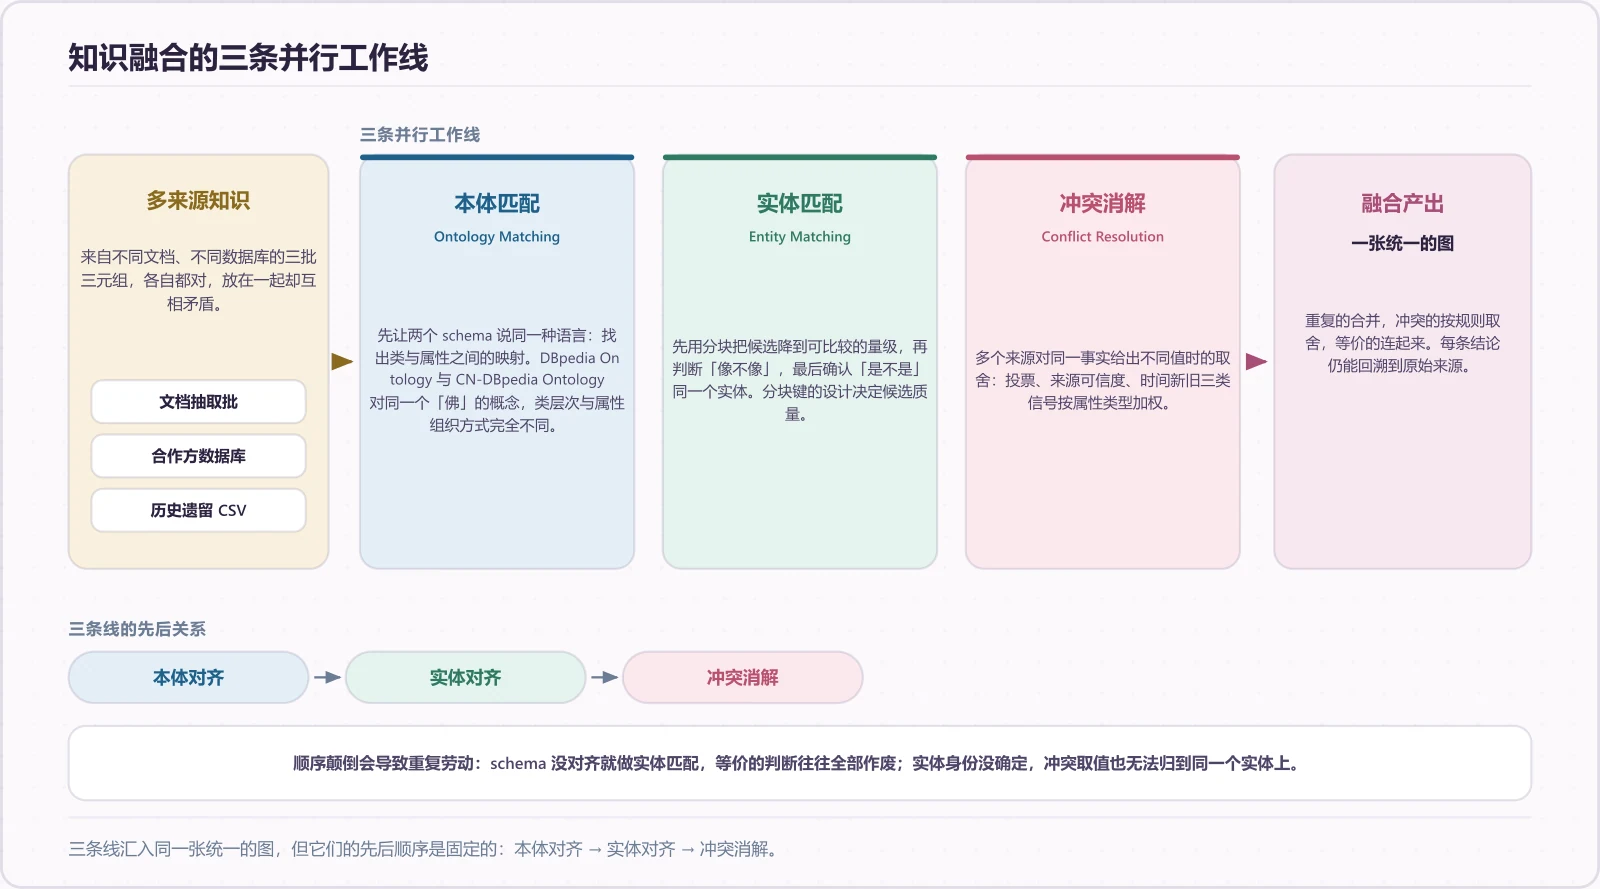
术语定下来之后,剩下的技术分三块:本体匹配(模式层)、实体匹配(实例层),以及匹配过程中的冲突与不确定性处理。
三、本体匹配:先让两个 schema 说同一种语言
本体匹配(Ontology Matching)要做的,是找出两个本体之间的映射。拿 DBpedia Ontology 和 CN-DBpedia Ontology 对照着看:同一个「佛」的概念,两边的类层次和属性组织方式完全不同。DBpedia Ontology 的公开规模数字是 685089,它是类数、属性数还是三元组数在来源里没有说明,此处只作保守引用。YAGO 和 GeoNames 各是 10,000,000 量级的实体规模。
对不齐的后果有量化结论:缺乏合理的匹配抽取方法会导致结果明显下降,有些情况下降 20%~30%。这不是掉一两个点的问题,是方案能不能用的差别。
相似度从哪来:一条方法谱系
「怎么算两个东西像不像」从最朴素的办法一路排到语义办法,整理成一张表,可以当技术选型清单用。
| 层级 | 方法 | 要点 |
|---|---|---|
| 字符串 | Dice 系数 | `simDice(s,t) = 2 |
| 字符串 | Jaccard 系数 | `simJaccard(s,t) = |
| 字符串 | N-Gram | 把术语切成 n 元片段再比集合,对词序和轻微拼写差异更宽容 |
| 统计 | TF/IDF | 给出 tf 与 idf 的公式,sim = tf × idf,特点是简单,属于向量空间模型 |
| 统计 | 虚拟文档(Virtual Document) | 把本体的每个元素扩展成「文档」再比:一类用名称、标签、注释,一类用属性值等语言信息 |
| 结构 | 相似度传播(Similarity Propagation) | 邻居相似会带动自身相似,迭代下去 |
| 结构 | Similarity Flooding | 该图匹配算法拿过 ICDE 2002 最佳论文,也是 ICDE 2013 Influential Paper |
| 结构 | 锚点(Anchor) | 先定少量高置信匹配当锚点,用它发现直接匹配找不到的匹配,也算间接相似度 |
| 表示学习 | 表示学习 / 余弦相似度 | 利用本体的名称、标签、注释、属性值等构建表示,用余弦相似度算相似度 |
| 表示学习 | 图神经网络 | 前沿部分的核心(AliNet、PCG-Matcher),把结构信息进网络 |
相似度算完不等于匹配就对了,还要解一对一约束怎么满足。这里要引入稳定婚姻问题(Stable Marriage Problem) 和 Gale–Shapley 算法,定理是:该算法保证对任意问题实例都能找到稳定匹配。
匹配抽取本身有两种思路:直接匹配靠文本、标签、属性值和已有锚点;间接匹配靠邻居和结构。
几个值得看的真实系统
Lily 是其中介绍得最细的系统,它的工作分成六个阶段。
| 阶段 | 时间 | 内容 |
|---|---|---|
| 语义子图的通用本体匹配框架 | 2006–2010 | 通用框架 |
| 大规模本体匹配 | 2008–2013 | 不需要划分本体 |
| 弱信息本体匹配 | — | 语义子图 + 相似度传播 |
| 本体匹配调试 | — | 据称是首次提出并给出启发式解决之一 |
| 本体匹配调谐 | — | 机器学习自动调谐 |
| 实例匹配 | 2013 至今 | — |
成绩是 2007 到 2021 年在 OAEI 上多次被评为 Benchmark 数据集最佳映射系统之一;解决大规模学术社交网络的作者名消解,F-Score = 0.987,在 KDD-CUP 2013 评测进了 TOP 10。TKDE 上 Pavel Shvaiko 与 Jerome Euzenat 那篇 Ontology Matching: State of the Art and Future Challenges 给过一句评价,原话是 "The two best systems of the last several years are ASMOV and Lily."。
同期对照系统是 Falcon-AO 和 RIMOM;RiMoM、ASMOV、Falcon 则是相似度传播的典型代表。
这段系统史给出的判断依据是:一个 2006 年起步、算法上没有用深度学习的方法,能在 OAEI 上稳定排到前列,说明匹配质量的大头在候选生成和约束设计,不在模型容量。上手先调模型的顺序是反的。
四、实体匹配:最花时间的部分
先解决「像不像」,再解决「是不是」
实体匹配可用的属性证据有一张很实用的清单。
| 证据 | 内容 |
|---|---|
| URI | 两边 URI 有稳定规律时直接可用 |
| Meta | 属性、时间、来源等元信息 |
| Name | 名称、标签 |
| Property Values | 属性值 |
| Neighbors | 邻居实体和关系 |
清单里前四项回答的是「像不像」,最后一项回答的是「是不是」。前者可以靠字面比较快速筛,后者必须看结构,代价高得多,所以工程上总是分两步走。
消歧的两类情况
实体消歧的两种情况正好相反:
- 多义词(polysemy):一个名字对应多个实体。例子是 NewYork / NewYorkCity / NY / BigApple 这类写法,背后可能指不同层级的东西。
- 同义词(synonym):多个名字对应同一个实体。
办法有三层:基于规则的(低复杂度,如 owl:sameAs 传递闭包、owl:InverseFunctionalProperty 这类函数式属性,比如 foaf:mbox,一个邮箱唯一确定一个人);基于相似度的(TF/IDF 统计、SVM、主动学习);以及基于分块的工程手段。
判定等价也不止 owl:sameAs 一条路,还有 owl:differentFrom(明确不等)、owl:InverseFunctionalProperty、owl:cardinality / owl:maxCardinality 这类基数约束,能间接表达「这两个不可能等价」。
在实际工程里,owl:differentFrom 的价值常被低估。sameAs 写错一条就污染整张图,differentFrom 写错只影响局部,而且它能帮候选集砍掉一大截。合理做法是在融合流水线里把否定证据当成一等公民。
匹配不动的部分靠分块
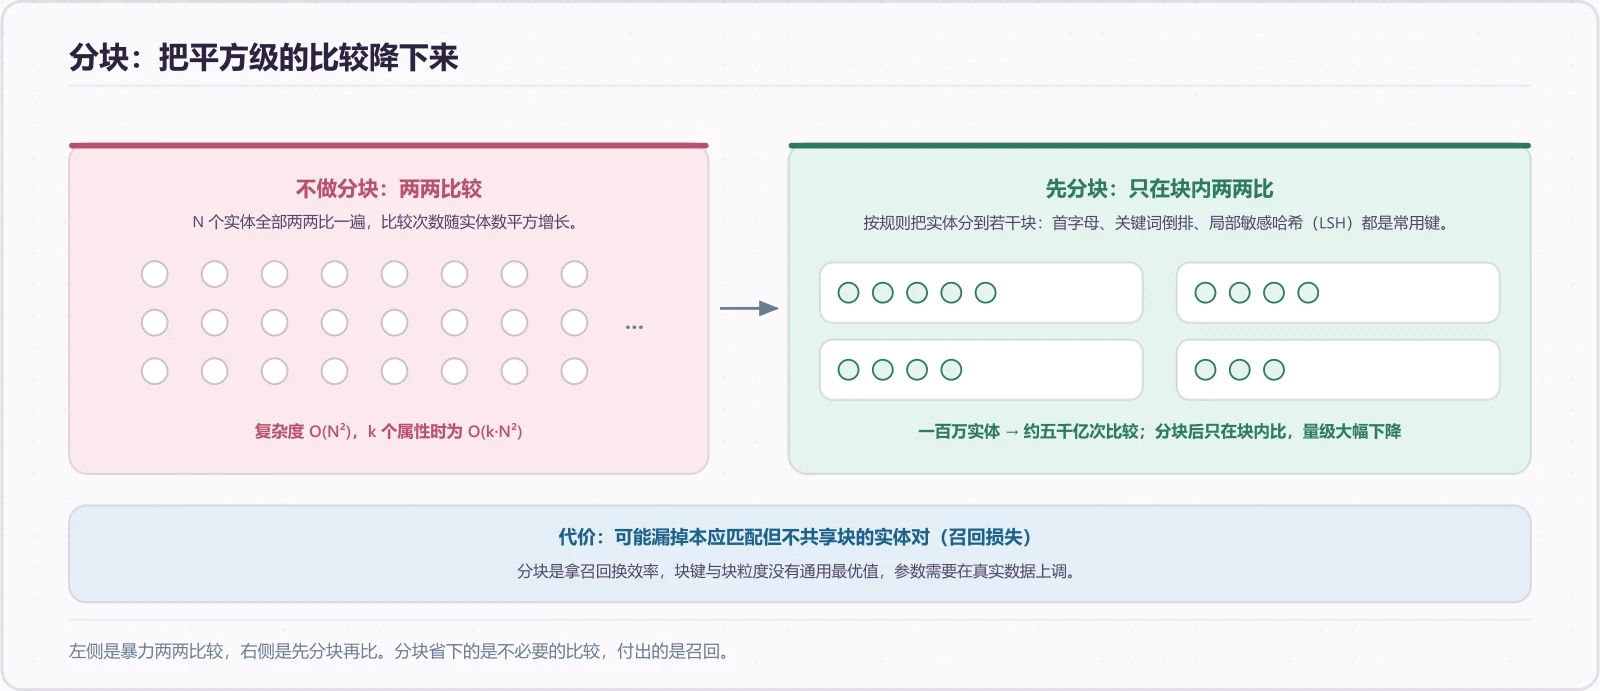
实例匹配的朴素做法是两两比。复杂度很清楚:pair-wise comparison 是 O(k·n²)(k 为属性数),另一处给出的口径是 O(N²)。百万级实体就崩了。
所以有分块(blocking):先用一个便宜的键把可能匹配的记录放进同一个块,贵的比较只在块内做(Papadakis 等,TKDE 2013,A blocking framework for entity resolution in highly heterogeneous information spaces)。
分块的取舍是这一块里最贴近工程的一段,两个方向正好相反:
| 维度 | 分块越细会怎样 |
|---|---|
| 匹配效果 | 分块冗余越多,未命中的匹配越少 |
| 匹配性能 | 不必要的匹配计算越多 |
实际手段有几种:LSH(位置敏感哈希)、多索引 + 候选选择(Li 等,KBS 2013,Large scale instance matching via multiple indexes and candidate selection)、元分块(Meta-blocking)、并行化。并行那份是 Efthymiou 等,Information Systems 2017,Parallel meta-blocking for scaling entity resolution over big heterogeneous data,结果很直观:匹配结果的计算从 14 天压到 95.5 分钟。另有 MapReduce 构建虚拟文档做本体匹配的工作(Zhang、Hu、Qu,JIST 2011)。
规模上还有一条分而治之的路子。Hu、Qu、Cheng 在 DKE 2008 提出 Matching large ontologies: A divide-and-conquer approach;Wang、Zhou、Xu 在 IJCAI 2011 更进一步,用归约锚点(reduction anchors)跳过大批相似度计算,依据是匹配具有局部性,某区域的组件多半落到对方某个区域,于是有「若 ai 不匹配 bx,则 ai 的邻居也不匹配 bx」。风险也标得很清楚:负锚点传播会出错。
一段能跑通的骨架
下面的伪代码把整条流水线固定下来。关键在第 3 步:先把候选砍到几万对,再上贵的模型,这是流水线里唯一能救性能的地方。
# 融合流水线骨架:分块 -> 块内打分 -> 一对一抽取 -> 写回
# 关键:相似度函数 sim() 可以换成 embedding/GNN,但分块必须先做

def fusion_pipeline(kg_a, kg_b, attrs, th_hi=0.92, th_lo=0.65):
    pairs = []                                    # 1) 生成候选:块内比较,不两两比
    for key_a, bucket in build_index(kg_a, attrs).items():
        for rec_a in bucket:
            for rec_b in build_index(kg_b, attrs).get(key_a, []):
                pairs.append((rec_a, rec_b))      # 键 = 规范化后的属性值/LSH 签名

    scored = []                                   # 2) 块内精算:字面 + 统计 + 结构三路加权
    for rec_a, rec_b in pairs:
        s = (0.4 * name_sim(rec_a, rec_b)         # 名称、标签
             + 0.4 * value_sim(rec_a, rec_b, attrs)  # 属性值,可上 TF/IDF 或 embedding
             + 0.2 * neighbor_sim(rec_a, rec_b))     # 邻居/结构
        if s >= th_lo:
            scored.append((s, rec_a, rec_b))

    accepted = []                                 # 3) 一对一抽取:按分数降序贪心,冲突的先挂起
    used_a, used_b, review = set(), set(), []
    for s, rec_a, rec_b in sorted(scored, reverse=True):
        if s >= th_hi and rec_a.id not in used_a and rec_b.id not in used_b:
            accepted.append((rec_a, rec_b))
            used_a.add(rec_a.id); used_b.add(rec_b.id)
        elif th_lo <= s < th_hi:
            review.append((rec_a, rec_b))        # 灰区进人工队列,不要自动合并
    return accepted, review                        # 4) 写回:sameAs 入图,review 进标注平台
三段式阈值比单一阈值好用的地方在于,它把「错合并」和「漏合并」分开治:th_hi 以上自动合并,th_lo 到 th_hi 之间进人工队列,th_lo 以下直接丢。错合并要回滚,代价很高;漏合并只是少一条边,代价很低。两条线的阈值不该一样。
五、冲突消解:三个库说三个数,信谁
到这一步,「这是同一个实体」已经认下来了,但认下来之后新问题才露头:这个实体的成立时间,库 A 写 1998,库 B 写 1999,库 C 写 2001,合并后保留哪个?
这类问题在教科书里叫真值发现(Truth Discovery),也叫冲突消解。它在知识融合框架里通常叫「冲突消解」;其中概率性的一条思路是 Dempster–Shafer 理论(仍是 CIKM 2012 那篇 An effective Rule Miner for Instance Matching in A Web of Data)。
需要提前说明的是,真值发现是整块内容里资料最薄弱的一环。多数教材只有「冲突消解」这个名目,没有能直接照搬的方法、公式或数据集。下面这段是按通用做法整理的思路,应作为参考方向而非定论。
通用思路:可靠度与置信度互相迭代
- 先按各数据源的历史准确率给权重
- 用加权投票定出每个属性的取值
- 定完之后反过来更新源权重
- 回到第二步,直到取值与权重都稳定
它和实体对齐是耦合的:对齐错了源可靠度就算错,源可靠度错了对齐打分也跟着偏,因此两个模块不适合串成单向流水线。
三类取舍信号
当多个来源对同一事实给出不同值时,可用的判断依据大致只有三类。
| 信号 | 含义 | 局限 |
|---|---|---|
| 投票 | 多数来源一致的取值优先 | 三个库互相抄同一份原始数据时,投票会一起错 |
| 来源可信度 | 按各源历史准确率加权 | 权重本身依赖对齐结果,需要迭代 |
| 时间新旧 | 时效性强的属性取更新的值 | 对机构成立时间这类属性无效,旧值才是对的 |
这三类信号没有一条能单独用。合理的组合方式是按属性类型配置权重:时效性强的属性(注册资本、股价)以时间为主,稳定的属性(成立日期、出生地)以来源可信度为主,投票作为兜底。
六、评测:值得记下来的那些锚点
评测资源不多,但都是可用的锚点。
- OAEI(Ontology Alignment Evaluation Initiative),本体匹配的国际竞赛,Lily 在 2007–2021 年多次被评为 Benchmark 数据集最佳系统之一。其中 OAEI 2015 的 Instance Matching Task 值得注意:任务目标、数据集描述,以及准确率、召回率、F1 这组指标。
- KDD-CUP 2013,作者名消解任务,有公开的 leaderboard,Lily 进了 TOP 10。
- OpenKG,当时已收录 76 个中文数据集,其中融合了几个百科类数据集:Zhishi.me、CN-DBpedia、PKU-PIE、Belief Engine。
实体规模的量级参考
| 数据集 | 实体数 | 备注 |
|---|---|---|
| CN-DBpedia | 16,546,273 | — |
| Zhishi.me | 10,337,505 | 来源 zhwiki、互动百科、百度百科 |
| PKUBase | 11,554,258 | — |
| Belief Engine | 1,423,828 | currently, hudongbaike |
| XLore | 10,856,042 | label only |
两两重叠的规模也不小(公开版本的实体数现已上涨):CN-DBpedia–Zhishi.me 5,393,835;CN-DBpedia–PKUBase 6,347,721;CN-DBpedia–Belief Engine 1,538,865;Zhishi.me–PKUBase 5,687,428;Zhishi.me–Belief Engine 697,123;PKUBase–Belief Engine 552,066。
更有价值的是它们怎么链接的
| 做法 | 要点 |
|---|---|
| 繁简转换后严格匹配 | 通过繁简转换后的实体名严格匹配 |
| 别名扩展 | 利用 Wikidata 扩展别名 |
| 属性扩充别名 | CN-DBpedia 与 Zhishi.me 的链接,用 CN-DBpedia 中具有别名含义的属性扩充实体别名 |
| 无法扩展的情况 | PKUBase 里没有可用的具有别名含义的属性,因此它没有上述链接过程 |
| 完全不同的路子 | Belief Engine 用互动百科唯一的 "article title" 与 Zhishi.me 中的互动百科实体链接 |
后两行值得多看一会儿:同一批数据、同一个团队,四个库用了四套链接策略,因为可用的证据本身不一样。这比任何「最佳实践清单」都更接近真实情况:融合方案是被数据决定的,不是被算法决定的。
七、前沿进展:结构匹配与图神经网络
这一块的结构很清楚:几个新模型,加上生物医学领域的本体匹配。
MCA
MCA 的关键模块如下。
| 模块 | 作用 | 关键式子 |
|---|---|---|
| Self-attention | 在同一句话内不同位置的词之间建立联系,捕捉长程与局部依赖,帮助词消歧 | h = Bi-GRU(e),α = softmax(hᵀh),ĥ = h·αᵀ |
| Pair-attention | 两个输入序列之间做软对齐和成对 token 比较 | β = softmax(e_A W e_B),p = ĥ·βᵀ |
| Fusion module | 用 highway network 聚合 ĥ 和 p |
u = Highway([ĥ, p, ĥ-p, ĥ⊙p]),Highway(x) = g·H(x, W_H) + (1-g)·x |
| Gate mechanism | 给原始词向量 e 和聚合表示 u 两个通道分配权重 |
g = σ(W_e·e + W_u·u + b),v = g·e + (1-g)·u |
| Global attention | 得到整条文本记录的表示 | λ = softmax(vᵀc),s = v·λᵀ |
| Binary classifier | 输出匹配概率 | s = Highway(s_A, s_B, s_A-s_B, s_A⊙s_B),P(y|T_A,T_B) = softmax(w·s + b) |
此外还有 extended structural EM:把文本编码用在属性上,用 Highway 和 Fusion 推导属性级的 pair 表示。
Hier-Matcher
| 层 | 做什么 | 关键式子 |
|---|---|---|
| Cross-Attribute Alignment | 跨属性做 token 对齐,用全局选择机制给每个 token 挑对方实体里最像的一个 | C = |h ⊗ e - H| → G = HighwayNet(C) → v = softmax(wG + b) → 取最大位置得选择向量 s → r = C·sᵀ |
| Attribute-aware Attention | 属性级比较结果 = 该属性所有 token 比较结果的加权和,权重 α 由属性上下文向量 p(随机初始化、联合学习)算出 |
r = Σ_t α_t·r_t |
| Entity Matching Layer | 属性级结果拼成 2u(m+n) 维证据向量,过两层全连接 ReLU HighwayNet + softmax |
P(y=1|e, e') |
AliNet
AliNet 是几篇里最完整的一个,它的设计要点有六条。
- 两个出发点:同构结构是有益的,但只有结构不够;对齐信息可以跨 GNN 层和同构图传播,前提是邻域有部分预对齐。这里还有一个提醒:常规 GNN 刻画不了三角形图这类特殊子图。
- 远距离邻居的补偿:schema 异质性会让对应实体的直接邻居和远距离邻居混在一起,而远距离邻居的聚合必须有注意力、有选择。
- 门控多跳聚合:一跳用原始 GCN,两跳改用注意力(沿用 GCN 的聚合会让噪声在层间传播),再用门控合并。远距离注意力为
c = LeakyReLU[(M₁h)ᵀ(M₂h)],softmax 归一化后跨实体可比。 - 对比对齐损失:已对齐实体拉近、未对齐推远;实体表示取所有层隐表示的拼接,因为每层都在传播对齐信息。总目标
L = L_a + α₂L_r。 - 关系语义建模:为省参数,不引入关系专属 embedding,关系表示由相关实体 embedding 检索得到,再最小化关系损失精修。
- 邻域增强:一方有边另一方没有时补一条平衡边,缓解非同构。对齐预测为
i' = argmin π(h_i, h_j)。
PCG-Matcher
PCG-Matcher 分四步。生成 PCG 用 LSH 选出等价可能性高的实体对当节点;属性特征生成先算属性对的相似度矩阵(用 Jaccards(s,t) = |NG(s)∩NG(t)| / (NG(s)∪NG(t))),再用 CNN 把稀疏矩阵编码成短稠密向量,并把名称相似度拼成 z = [z₁, z₂, z₃, z₄],四项分别是 string equality、edit distance、Jaccard similarity、substring similarity;属性特征传播用边感知注意力,注意力由节点特征算出,边类型向量由它连接的节点向量计算;残差连接让输入输出维度取同,节点表示由 h⁽⁰⁾ 与 h⁽ᴸ⁾ 逐元素相加,好让实体对 embedding 记住原始属性特征。
生物医学方向
Matching Biomedical Ontologies: Clues, Approach, and Scalability 这篇只剩标题,正文不可得,无法说明它讲了什么线索、什么方法和什么扩展性结论,因此不作介绍。
八、落地路线建议
规则与模型的配比
先写规则再上模型,不要反过来。理由就在那个 20%~30% 的数字里:匹配抽取方法不对,模型再好也白搭。
按 7:3 起步是一个可用的分法:七成工作量花在规范化(繁简转换、大小写、全半角、单位统一、别名表)和分块键设计上,三成花在打分模型上。OpenKG 那「四套链接策略」就是证据。决定结果的不是你用 BERT 还是 GNN,而是 PKUBase 里到底有没有「别名含义的属性」。
阈值怎么定
从库里抽 200~500 对人工标一遍,算不同阈值下的错合并率和漏合并率,再选点。经验上错合并的代价是漏合并的 10 倍以上:错合并要拆边、要重算下游指标、要向业务方解释为什么两个客户成了一个;漏合并只是少一条边。所以宁可把 th_hi 定高、把灰区放宽,用人工队列兜住。
可撤销的融合流水线
这是融合和其他知识图谱模块最不一样的地方,要提前设计。
| 要求 | 做法 | 理由 |
|---|---|---|
| 等价边单独成批次 | 带上批次 id、生成时间、模型版本参数、命中的规则,而不是直接往主图里塞 owl:sameAs |
出问题时能整批回滚 |
| 边可撤销 | 用 sameAs 的传递闭包时,存边而不是只存闭包结果 |
一条错边会把两个连通分量粘死,撤销时得能定位到是哪条边粘的 |
| 已合并属性保留多值与来源 | 冲突时先别选真值,把候选值连同来源和时间留着 | 等真值发现模块或人工裁决,而不是覆盖 |
| 灰区进人工队列 | 审核人看到的必须是证据(名称、属性值、邻居对比),不是一个分数 | 单个分数无法判断,证据才能判断 |
把这些要求合起来看,融合产出的是关于实体的假设,不是事实。假设有置信度、有生命周期、有撤销路径,把它当成可反复推翻的推理层,比当成一次性清洗安全得多。
九、小结
知识融合的三条工作线有明确的先后关系:本体匹配让两边的 schema 说同一种语言,实体匹配在此基础上判断哪些记录指向同一个实体,冲突消解处理同一属性上的不同取值。顺序颠倒会导致重复劳动:schema 没对齐就做实体匹配,匹配上的结果很可能在 schema 对齐后全部作废。
三条线里,决定成败的是前两条线上的候选生成与约束设计,而不是打分模型的容量;而唯一不能事后补救的是第三条线上的可撤销性,它必须在建流水线时就设计进去。