前面几篇里,图谱一直是一堆三元组,(北京, 是…的首都, 中国) 这样。看图直观,交给机器就别扭:每种查询都要写专门的图算法;图上只出现一两次的长尾实体,语义基本学不出来。
这一篇交代两件事:图谱怎么变成向量,以及大模型时代这套东西还有没有用。前半部分是表示学习的三代方法,后半部分是知识图谱与大模型的双向关系。
一、从独热到稠密向量
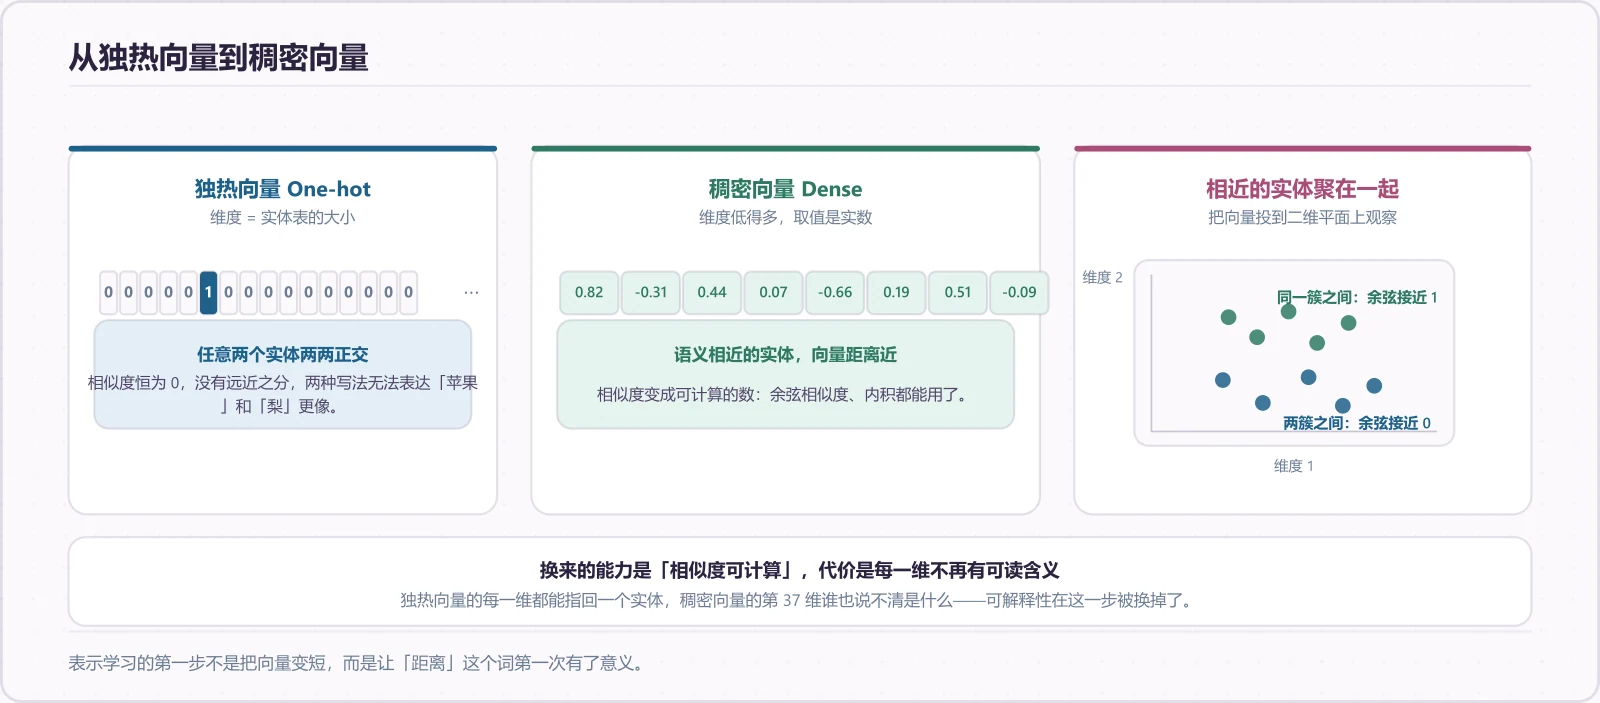
独热表示(one-hot representation)最能说明符号表示的病灶:每个对象都假设独立,向量里只有一位是 1。「苹果」是 (0,1,0,0,0,0,0),「香蕉」是 (0,0,0,1,0,0,0),两条向量内积为 0。机器眼里苹果和香蕉的关系,跟苹果和一块石头没有区别。
表示学习(representation learning)把研究对象表示成低维稠密向量;落到图谱上叫知识表示学习(knowledge representation learning, KRL),把实体和关系映射进同一个低维稠密空间。
它的意义可以收成三条:
| 收益 | 含义 |
|---|---|
| 计算效率 | 低维向量替代高维稀疏表示,降低存储与计算开销 |
| 缓解数据稀疏 | 稠密向量让长尾实体也能获得可比较的表示 |
| 表示形式统一 | 多源异质信息的表示形式统一,便于迁移和融合 |
第三条是后面全部故事的地基。知识只能以「节点-边」的形式存在时,它和大模型的 token 序列之间没有公共语言;两边都能变成向量,融合才有可能。
二、翻译模型:把关系当成一次平移
翻译距离类的出发点很朴素:把关系 r 看成从头实体 h 到尾实体 t 的一次平移,理想情况下 h + r ≈ t。TransE 的得分函数就是这个假设的度量,取 L1/L2 距离形式:
用代码看得更清楚:
import torch
import torch.nn as nn
import torch.nn.functional as F

class TransE(nn.Module):
    """关系 = 从头实体到尾实体的一次平移。"""

    def __init__(self, num_entities, num_relations, dim=100, p=2):
        super().__init__()
        self.entity = nn.Embedding(num_entities, dim)
        self.relation = nn.Embedding(num_relations, dim)
        self.p = p
        # 初始化:均匀采样后统一归一化
        nn.init.uniform_(self.entity.weight, -6 / dim ** 0.5, 6 / dim ** 0.5)
        nn.init.uniform_(self.relation.weight, -6 / dim ** 0.5, 6 / dim ** 0.5)
        with torch.no_grad():
            self.entity.weight.copy_(F.normalize(self.entity.weight, p=2, dim=1))
            self.relation.weight.copy_(F.normalize(self.relation.weight, p=2, dim=1))

    def forward(self, h, r, t):
        h, r, t = self.entity(h), self.relation(r), self.entity(t)
        # 得分 f(h,r,t) = ||h + r - t||,越小越好
        return (h + r - t).norm(p=self.p, dim=-1)

def train_step(model, pos, num_entities, margin=1.0):
    """正例取真实三元组,负例用替换头/尾实体的方式构造。"""
    h, r, t = pos.unbind(dim=1)
    corrupt_head = torch.rand(h.size(0)) < 0.5      # 一半改头,一半改尾
    neg_h = torch.where(corrupt_head, torch.randint(0, num_entities, h.shape), h)
    neg_t = torch.where(corrupt_head, t, torch.randint(0, num_entities, t.shape))
    # 正例得分 + margin 要小于负例得分
    return F.relu(margin + model(h, r, t) - model(neg_h, r, neg_t)).mean()
那个负例构造方式是整条线上很多问题的源头。TransE 的短板也很清楚:处理不好 1-N、N-1、N-N 复杂关系,同一个关系连到同一个尾实体时,多个头向量为了同时满足 h + r ≈ t,只能被推得几乎一样。
翻译族的三条改进线索
这一族名字有十几个,抓住线索就不必死记:TransR/TransD/TranSparse 在给关系配更合适的变换,TransM/TransF/ManifoldE 在放松约束本身,KG2E/TransG 干脆承认表示带不确定性。
| 模型 | 相对前作改了什么 | 主要代价 |
|---|---|---|
| UM / SE | UM 只用头尾共现(-||h-t||),关系不参与;SE 把关系建模为分别作用于头、尾的两个矩阵 |
UM 近似简化版 TransE;SE 结构简单 |
| TransE | h + r ≈ t,参数少、效果好 |
处理不了 1-N/N-1/N-N |
| TransH / TransR / CTransR | TransH 让每种关系是一个超平面,头尾投影上去再平移;TransR 给每个关系一个映射矩阵,映射到该关系的语义子空间;CTransR 再把同一关系下的实体对分类 | 同一关系的头尾共享映射;参数量急剧增加 |
| TransD / TranSparse / TransA | TransD 把实体、关系各嵌入为语义向量 + 映射向量,动态生成映射矩阵;TranSparse 用自适应稀疏矩阵替代一般映射矩阵,稀疏度由关系连接的头尾对数量决定;TransA 把距离度量换成马氏距离,为每一维学不同权重 | 表达式更复杂;TransA 每关系一个非负对称矩阵 |
| TransM / TransF / ManifoldE | 都在放松平移约束:TransM 按关系的映射性质加权;TransF 只要求 h+r 与 t 方向一致;ManifoldE 放宽成流形,即以 h+r 为球心、D_r 为半径的球面 |
约束变松,各引入新的先验或超参 |
| KG2E / TransG | 用高斯分布表示实体和关系:均值是语义中心,协方差是不确定度;TransG 认为同一关系连不同实体对时语义不同,故关系分布取高斯混合 | 从点变分布,计算与训练变重 |
三、语义匹配模型:不建模距离,建模「配不配」
另一条路不假设平移,直接用函数给 (h, r, t) 打一个「合理程度」的连续分数。
| 模型 | 核心做法 | 关键代价 / 局限 |
|---|---|---|
| LFM / RESCAL | 基于关系的双线性变换 h^T M_r t,刻画实体与关系的二阶联系;RESCAL 是张量分解代表,优化张量全部位置(含 0),LFM 只优化确实存在的三元组 |
每个关系一个满矩阵,RESCAL 参数规模巨大 |
| DistMult / ComplEx | DistMult 把 M_r 限制为对角阵,复杂度大降;ComplEx 把表示扩展进复数向量空间,取 Re(h^T diag(M_r) t) |
对称化打分,难建模非对称关系;复数运算开销 |
| ANALOGY / HolE | ANALOGY 专攻类比推理(太阳之于行星,如原子核之于核外电子),用正规性、交换性约束关系矩阵;HolE 用循环相关捕获实体语义关联 | 建模自由度损失;计算涉及循环相关 |
| SLM / NTN / MLP / NAM / ConvE / ConvKB / AprilE | 神经网络与卷积打分;NTN 用张量网络捕获头尾语义关联;MLP、NAM 用多层网络关联头尾;ConvE 系列用卷积捕获语义关联与全局关系;AprilE 加三元组级注意力与伪残差连接 | NTN 三阶张量参数大;可解释性弱;卷积类超参更多 |
两个细节值得单说。DistMult 只是把关系矩阵压成对角阵,按常理是「降级」,效果却显著提升,参数少了反而不容易过拟合。ComplEx 的动机也干净:DistMult 因为对称性打不了非对称关系,那就把表示搬进复数空间,实部取分数,非对称性从虚部来。
四、图神经网络那一支,以及翻译族的表达力上限
前沿进展这条主线是从欧氏空间走到非欧空间,再从纯嵌入走到 GNN。
双曲空间
HBE 的论证很有说服力:现实网络常表现为潜在的树状结构,双曲空间是树的连续版本,比欧氏空间更准确简洁地表示分层数据。任何有限树都能以任意低失真嵌入有限双曲空间,而欧氏空间以多项式速率扩张,无限维也做不到。
做法上,HBE 用扩展的庞加莱球(Poincaré ball)配合极坐标抓层次信息,用切线空间与指数变换做初始化与映射,并用 tanh 缩放模长拉伸边界,缓解球边界附近的浮点精度不足。评测在 WN18RR、FB15k-237 上做。
混合曲率 + GNN
多关系图谱天然异构,既有层次结构也有循环结构,塞进单曲率空间就会丢信息。M2GNN 于是构建由球面、双曲线、欧几里得三种空间笛卡尔积成的混合曲率空间,把曲率当成可学习参数学出来,再用 GNN 聚合邻域实体与关系的特征更新嵌入,结论是优于任何单曲率方法。
表达能力与关系模式
PairRE 先给复杂关系一个量化判据:对关系 r,用平均每个头实体对应的尾实体数 tphr 和平均每个尾实体对应的头实体数 hptr 判断,两个都小于 1.5 是 1-1,都大于 1.5 是 N-N,否则偏向 1-N 或 N-1。
接着它列出五种关系模式:对称、反对称、自反、组合、子关系。它的判断是此前方法做不到同时处理「复杂关系」和「编码各类关系模式」,办法是为每个关系学一对向量,让损失里的 margin 自适应调整。数据集用 ogbl-wikikg2、FB15k、FB15k-237、DB100k、Sports,其中 wikikg2 里对称关系最有挑战,FB15k-237 主要是反对称和组合模式。
更根本的线索来自 SE-GNN:KGE 的外推(extrapolation)为什么行得通?这可以归纳成三类 Semantic Evidence。
| 层级 | 内容 |
|---|---|
| 关系级 | (h_i, r, ?) 里 r 本身含有能预测 t 的信息 |
| 实体级 | h 与 t 通过直接或间接关系相连时,时空语义相关性更强 |
| 整体级 | h 与 t' 的关系可迁移到与 t' 相似的 t |
SE-GNN 把这三层信息通过 GNN 的邻居聚集机制编进嵌入,数据集是 FB15k-237 和 WN18RR。
五、训练、负采样与评测协议
损失函数的形状能还原出来:拉近正例得分、推远负例得分,中间隔一个 margin;负例靠替换正例的头或尾得到。
这个做法有一个被讲透的毛病,PUDA 管它叫「错误负例」:不存在的实例既可能是负例,也可能是没被收录的正例,直接当负例会把模型往错的方向拉。它的对策是把破坏得到的三元组当成「正例-无标签」(Positive-unlabeled)而非负例,改进 PU 风险估计器;另一头用对抗数据增强合成三元组解决稀疏。正例的稀缺程度可以量化:WN18RR 中真三元组只占可能三元组的 0.00047%,FB15k-237 是 0.00054%。合成三元组也不能当正例,只能作无标签样本。
评测协议
| 任务 | 定义 | 指标 |
|---|---|---|
| 链接预测(link prediction) | 预测三元组中丢失的头实体或尾实体,输出是所有候选实例的得分排名,而非直接给出最匹配实例。例:(南京, 是…的城市, 中国) |
MRR:所有原始三元组排名倒数的平均值;Hits@N:原始三元组排名不大于 N 的比例 |
| 三元组分类(triple classification) | 二分类:判断给定三元组是否真实存在于图谱中 | 准确率(Accuracy)、精确率(Precision)、召回率(Recall)、F1 |
常见数据集名单不短:WordNet(词义消歧、上下位与蕴涵关系)、Freebase(整合 WordNet 与 Wikipedia,RDF 三元组模型)、YAGO(融合 Wikipedia、WordNet 与 GeoNames 的类别层次),再往外是 WN11/WN18/FB13/FB15K/FB1M/FB5M 这一串统计口径。
复现时要先确认的一件事
MRR 和 Hits@N 这两个指标只说了一半。真去复现还得先确认「过滤设置」(filtered setting)与原始设置的区别,否则数会差很多。
六、KG 与大模型:先看幻觉
大模型幻觉(hallucination)分两种形式:
- 事实幻觉(factuality hallucination):生成内容与可验证的真实世界事实之间的差异。
- 忠诚幻觉(faithfulness hallucination):生成内容与用户输入的分歧,或内容缺乏自洽性。它再细分三类:指令不一致(偏离用户原始指令)、上下文不一致(与所提供的上下文存在差异)、逻辑不一致(内容内部矛盾)。
成因按阶段铺开,这个分法比很多综述更细。
| 阶段 | 成因 |
|---|---|
| 数据(Data) | 预训练数据本身错误、带偏见;预训练知识边界受限、长尾知识(long-tail knowledge)薄弱;现实世界知识发展过快 |
| 训练(Training) | 对齐指令过于复杂多样;对齐数据可能引入与预训练知识冲突的内容;人类偏好设置不合理导致 sycophancy(奉承) |
| 推理(Inference) | 解码策略引入随机性;过度遵循流畅性而忽视遵循上下文;over-confidence;注意力机制存在局限导致推理失败,多跳与复杂关系知识上尤其吃力;响应超出查询范围 |
推理阶段列出的最后几项,正好是知识图谱的主场。KG 抑制幻觉不是一句笼统的口号,而是逐条对着成因去的:长尾知识靠外部补,多跳知识靠结构补,来源可查靠可解释性补。
两条具体路径
KG-Based Retrofitting:先让 LLM 对自己的输出做声明提取(claim extraction),把待验证的声明用三元组表示成局部子图,再用启发式规则召回相关三元组,最后校验修正。它自己列了错误分析:实体提取粒度(entity extraction granularity)难拿捏,事实选择(fact selection)困难,召回的三元组噪声太多。
FactCHD:覆盖健康、医学、气候、科学等数据,流程是数据收集、上下文生成、证据链加人工筛选,问题类型有直接、多跳和集合操作。
七、GraphRAG:向量检索不够用的地方
RAG(retrieval-augmented generation)三步很直白:检索,从外部库检索相关片段,通常用向量检索做相似度匹配;增强,把片段与原始输入拼成「问题 + 上下文」;生成,模型基于增强输入给出答案。它的好处有四条:减少幻觉、动态更新、可解释性(知识有来源)、领域适配。
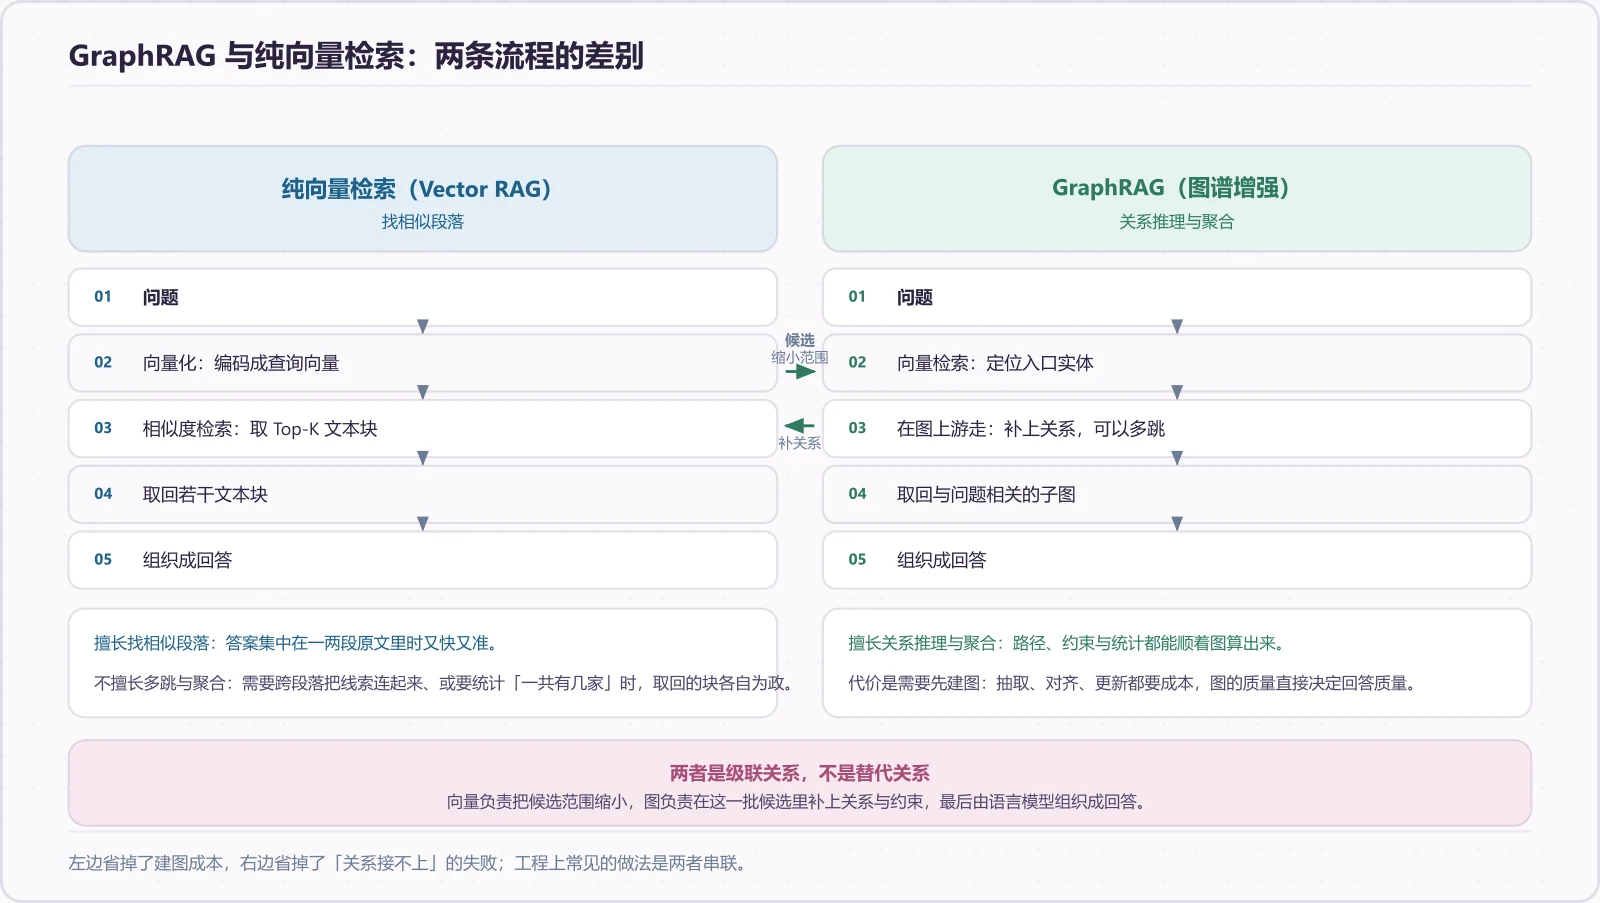
那 RAG 为什么不够?三条短板:
| 短板 | 具体表现 |
|---|---|
| 忽视关系 | 只理解文本表面意思,捕捉不到文本之间的复杂关系 |
| 冗余信息 | 拼接提示时经常以文本片段形式重述内容 |
| 缺乏全局信息 | 只能检索到部分文档,无法掌握全局 |
图检索为什么能补上,用伪代码固定下来更清楚:
# GraphRAG 检索:把"拼文本块"换成"查子图"
def graph_rag_answer(question, KG, llm, top_k=8):
    # 1) 定位:从问题里抽出实体/类型,锚定到图上的种子节点
    seeds = llm.identify_entities(question, onto=KG.ontology)
    # 2) 子图召回:沿关系多跳扩展,而不是切等长文本块(对应"忽视关系")
    subgraph = KG.expand(seeds, hops=2, max_nodes=200)
    # 3) 关系筛选:候选关系太多会淹掉上下文,按问题语义裁剪
    rels = llm.rank_relations(question, KG.relations_around(seeds))
    evidence = [tr for tr in subgraph.triples if tr.relation in rels.top(top_k)]
    # 4) 补一层社区/摘要信息,对应"缺乏全局信息"
    global_ctx = KG.community_summaries(subgraph.communities)
    # 5) 线性化三元组 + 全局摘要一起喂给 LLM
    return llm.answer(question, triples=evidence, global_context=global_ctx)
第 3、4 步是重点。RAG 的检索单位是文本块,GraphRAG 的检索单位是节点、路径和子图,所以它能把「日本」和「秋田犬」之间那条靠语义相似度很难命中的潜在关系显式拿出来。
代价也得认:图构建本身有成本,实体链接做错会把错误传播到整个子图。
八、反方向:LLM 来帮 KG
前面是 KG 救 LLM,另一半是反过来。
抽取与数据增强
OneKE 这类大模型知识抽取框架把抽取任务统一进一套框架。低资源那条线用本体兜住生成质量:ANGEL 解析本体层次结构来替换预先给定的实体类型,再让 LLM 增强并标注;ConsistNER 要求检索到的示范同时满足本体一致性(实体类型)和上下文一致性(句子语义),目标句里的「新年」是 EVENT 类型,示范里「新年」却是 DATE 类型,就会把模型带偏。
补全
MPIKGC 的痛点是:基于描述的补全方法只依赖关系名称,而关系名称表达不了复杂抽象关系;稀疏图上链接太少,长尾实体尤其吃亏。它的做法分四步。
| 步骤 | 内容 |
|---|---|
| 多角度 prompt | 用 LLM 补上下文 |
| 描述扩展 | 用思维链生成描述 |
| 关系理解 | 设 Global、Local、Reverse 三种提示,分别从整个图谱推断关系意义、从三元组推断含义并提示头尾实体类型、把关系写成动词再转被动语态 |
| 结构提取 | 再用 LLM 生成额外结构信息 |
评测用 FB15k237、WN18RR、FB13、WN11,baseline 分基于描述(KG-BERT、SimKGC、LMKE、CSProm-KG)与基于结构(TransE、DistMult、RotatE、ConvE)两类,指标 MR、MRR、Hits@1/3/10,结论是比四种基于描述的补全模型有明显提升。
图上推理
这一路更激进,不让表示学习上场。KG-GPT 和 StructGPT 都用 LLM 对结构化数据推理,路线不同:StructGPT 找从种子实体到答案实体的路径,KG-GPT 检索整个子图再推答案,所以除 KGQA 之外还能做基于 KG 的事实验证。
KG-GPT 分三步:句子分割,一句话拆成子句,每子句对齐一个三元组;图检索,按 schema 找出连接子句实体的候选关系集,让 LLM 选 top-K 关系,取对应三元组构成证据图池;推理,三元组线性化后和原句一起送进 LLM 得结论,回答时从证据图里挑最可能的答案实体。数据集 FACTKG 和 MetaQA,指标 MRR、Hits@1/3/10。
改模型知识
GLAME 关注的是,现有编辑方法没考虑目标知识的修改对关联知识的影响,而 LLM 的黑盒性质让捕获知识片段之间的关联变得复杂。把 "LeBron James plays for the Miami Heat" 改成 "…the Los Angeles Lakers",改一个事实,周边一串都该跟着动。同类工作还有 KELP 与 OntoFact。
两个方向放一起看
| 方向 | 代表工作 | 角色分工 | 解决的问题 | 新风险 |
|---|---|---|---|---|
| KG → LLM:幻觉校验 | KG-Based Retrofitting、FactCHD | KG 是外部证据与裁判 | 事实幻觉、长尾与多跳知识 | 实体提取粒度、事实选择噪声 |
| KG → LLM:图谱提示与检索 | KnowGPT、KELP、ERNIE、GraphRAG | KG 是结构化上下文、检索索引与全局视角 | 知识过时、忽视关系、冗余信息、缺乏全局信息 | 路径选错污染提示;实体链接错误传播 |
| KG → LLM:知识编辑 | GLAME | KG 定位关联知识 | 改一个事实影响一片事实 | 关联范围判断依赖图谱质量 |
| LLM → KG:抽取、补全与推理 | OneKE、ANGEL、ConsistNER、MPIKGC、KG-GPT、StructGPT | LLM 是抽取器、标注器与图上的推理者 | 标注数据稀缺、关系名称语义不足、长尾稀疏、多跳推理 | 标签一致性、LLM 事实性、子图规模与检索精度 |
这张表最该留意的是「新风险」那一列。KG 进 LLM 的链路每多一环,就多一个能把错误放大一整片的地方:实体链接错了,召回的子图、选出的路径、拼进提示的上下文全错,而 LLM 会流畅地基于错误证据继续编。所以「KG 抑制幻觉」的前提是链接和召回得先靠谱。
九、大模型时代,KG 的挑战和机会
有四条挑战写在 LLM 时代之前,放到今天看形状变了。
| 挑战 | 内容 |
|---|---|
| 大规模知识图谱的在线学习 | 图谱动态演化速度之快,如何开展在线学习以及知识的分布式表示 |
| 融合知识图谱丰富信息的表示学习 | 已有模型大多只利用了图谱中的一部分知识,如何融合多模态异构数据 |
| 面向开放域的知识表示学习 | 如何实现 Out-of-KB 实体的学习,这有助于解决图谱不完备与长尾数据问题 |
| 基于知识表示的应用 | 如何在知识融合、推荐系统、问答等任务上验证其有效性 |
前两条是「图谱本身不够用」,后两条是「知识得能走出去」。大模型恰好同时是这两个方向的推力和答案:它把知识的规模和新鲜度标准抬高到单个图谱维护不动的程度,自己又是长尾知识和开放域实体的大仓库。OOKB(out-of-KB)实体不必等图谱收录,MPIKGC 用 LLM 补上下文、KG-GPT 直接拿 LLM 在子图上推,都是在绕开「图谱必须先完备」这个前置条件。
角色变化
KG 在 LLM 时代不会消失,但角色会从「最终产品」变成「中间件」。价值不再主要是「我存了多少三元组」,而是三件事:让生成的依据可回溯、让多跳和全局问题有结构可循、让领域知识能以低成本注入和修订。
表示学习这门手艺也没有白学:GraphRAG 里超节点和社区摘要怎么做、KG-GPT 里关系怎么筛 top-K,本质还是「怎么把结构压进有限预算的上下文」,跟当年把图谱压成 100 维向量是同一类问题的不同粒度。
十、落地路线建议
复习顺序
先记住符号表示的病灶:独热、长尾、需要专门的图算法。后面所有模型的动机都能挂在这三句话上。
翻译族精读 TransE、TransH、TransR,其余变体知道它们在放松什么约束即可;语义匹配族精读 DistMult、ComplEx。然后亲手在 WN18RR 或 FB15k-237 上跑一遍 TransE 和 DistMult,把负采样一起理解掉。
要碰前沿,从 PairRE、HBE、M2GNN、SE-GNN 入手,它们覆盖关系模式、几何曲率、图结构、可解释性四个视角。接上 LLM 时先把幻觉的两类形式和三个阶段成因理清,再按「KG → LLM」和「LLM → KG」两条线各挑两篇读。
不要把精读变成刷论文数
TransE、DistMult、ComplEx 加一个 GNN 编码器,就够覆盖自己任务上绝大多数 baseline。真卡住的地方通常不在模型,而在数据质量、负采样和评测协议。
收尾
从 RDF 三元组到 GraphRAG,这几篇一直在同一件事上打转:怎么让机器既用上「知识是人组织好的结构」这个便宜,又不被这个结构的刚性限制住。这条路没有终点,只有问题清单。