关系抽取的输出形如 (中兴通讯, 客户, 中国联通),结构干净,但缺一个维度:这条三元组是什么时候成真的。同一对公司,2013 年的材料里写着「合作伙伴」,2015 年的新闻里写着「客户」。两条三元组同时放进图谱,图谱本身没有机制告诉你哪条在前,更不会告诉你「先成为客户、后变成合作伙伴」意味着什么。事件抽取要补的就是这个洞。
一、事件比关系多了什么
事件(event)的定义是:发生在特定时间点或时间段、特定地域范围内,由一个或多个角色参与的一个或多个动作组成的状态的改变。事件抽取(event extraction)则是从自然语言文本中抽取出用户感兴趣的事件,并以结构化形式呈现出来:什么人、什么组织,在什么时间、什么地点,做了什么事。
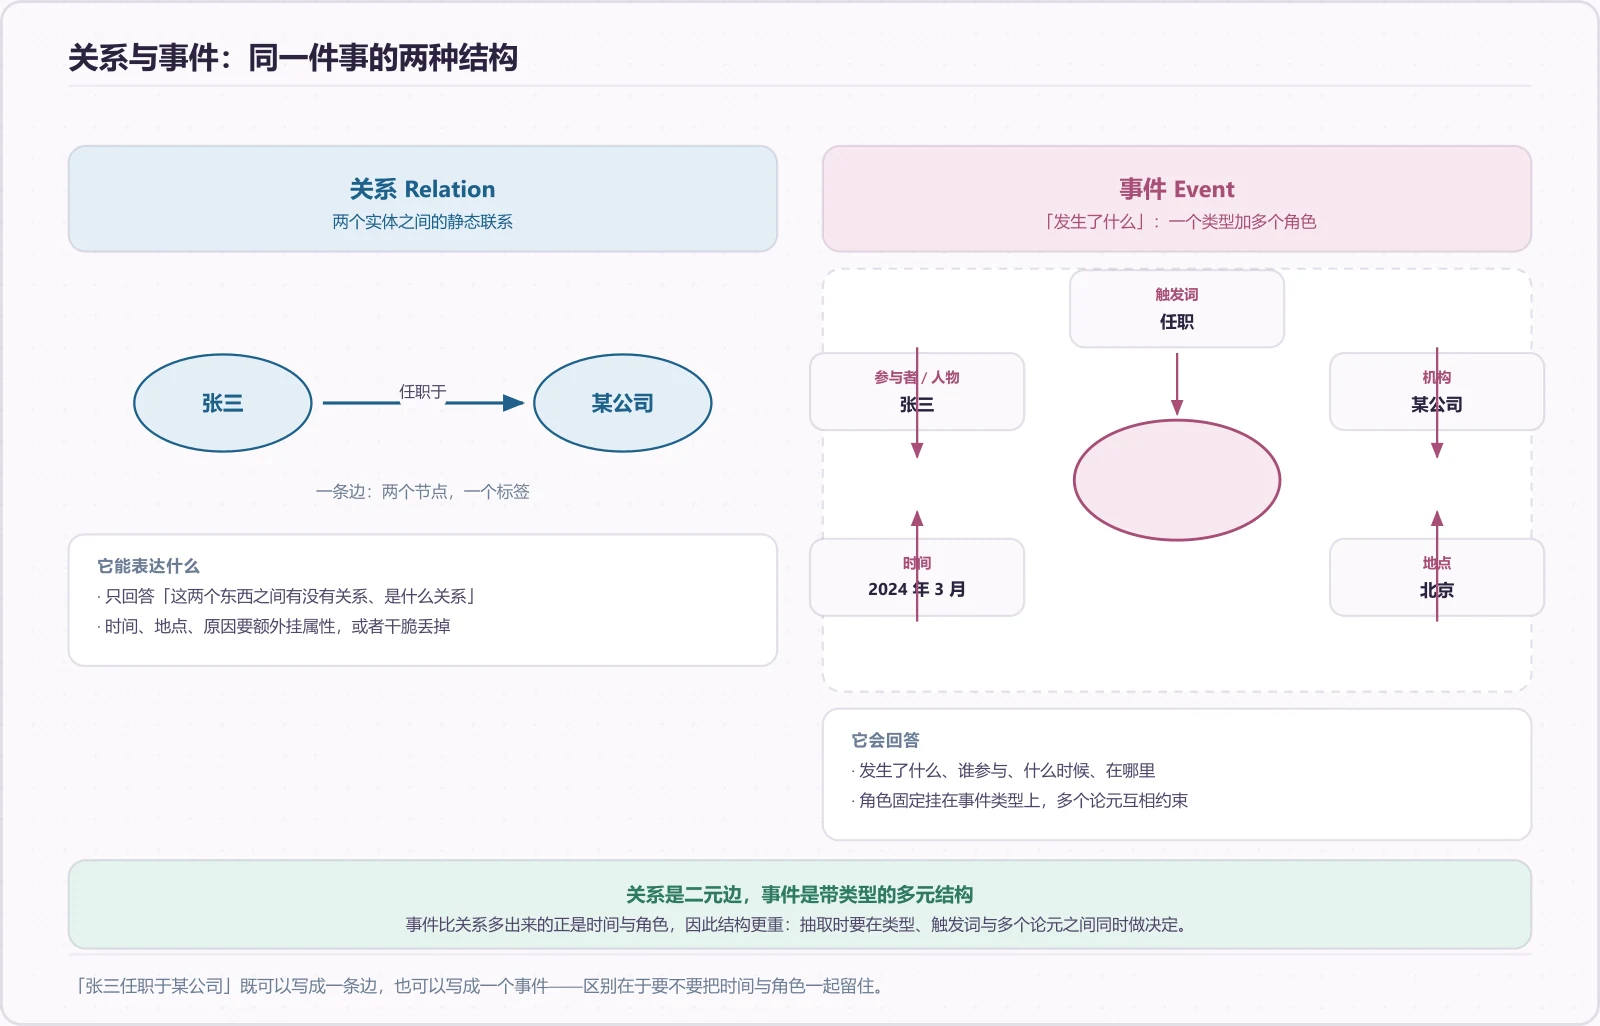
关系抽取盯着两个实体之间的语义关系,事件抽取盯着一个动作或状态改变,它的锚点不是实体对,而是一个词。ACE 评测里的经典例句可以说明这件事:
Barry Diller on Wednesday quit as chief of Vivendi Universal Entertainment.
触发词是 quit,标注出的事件类型是 Personnel/End-Position(人事/离职)。围绕这个词可以列出四组论元:Barry Diller/Person、Vivendi Universal Entertainment/Organization、Chief/Position、Wednesday (2003-03-04)/Time-within。这四组论元加上触发词,构成一个事件的最小完整形态。两类抽取的差别不在粒度,而在结构。
| 对比维度 | 关系抽取 | 事件抽取 |
|---|---|---|
| 基本锚点 | 实体对 | 事件触发词(动作/状态改变) |
| 输出单元 | 三元组(实体,关系,实体) | 事件实例:类型 + 触发词 + 若干(论元,角色) |
| 论元数量 | 固定为 2 | 可变,一种事件类型一套角色模板 |
| 时间与地点 | 通常不作为必需项 | 是一等角色,Time-within、地点都要单独标注 |
| 子任务 | 关系分类(实体通常已给定) | 触发词检测 + 触发词分类 + 论元识别 + 论元角色分类 |
| 错误传播 | 链条短 | 链条长,前一步错则全盘错 |
| 与图谱的关系 | 填充实体的属性与关系 | 补充动态事实、事件之间的关系 |
用一句话概括这个差别:关系抽取给图谱加上静态的边,事件抽取给图谱加上带时间戳、带参与者名单的动作节点,后者才能支撑「后来呢」这类追问。
事件抽取的两个子任务组
事件抽取拆下来是两个子任务组。
| 子任务组 | 包含的具体任务 | 英文名 |
|---|---|---|
| 事件发现 | 事件触发词检测、事件触发词分类 | Event Trigger Detection / Event Trigger Typing |
| 事件元素抽取 | 事件元素识别、事件元素角色识别 | Event Argument Identification / Event Argument Role Identification |
围绕这两个子任务组有四个基础术语:事件提及(Event Mention)指描述事件的那句话;事件触发词(Event Trigger)指标记事件类型的词汇;事件元素(Event Argument,也叫论元)指事件的参与者;事件角色(Event Role)指元素在事件句中扮演的角色。
二、事件图谱与事理图谱
事件知识比实体知识多出一层表达能力。实体知识那一栏是「刘备、关羽、张飞、桃树、酒」,事件知识那一栏写的是「东汉末年,刘备、关羽、张飞在桃园三结义」。后者多出来的不只是时间地点,而是动作本身成了可检索的单位。
事件图谱的定义是:包含事件、事件属性、事件间关联关系的,以事件为基本单位的知识网络。「基本单位」这四个字是关键,它和以实体为基本单位的知识图谱是两套骨架。
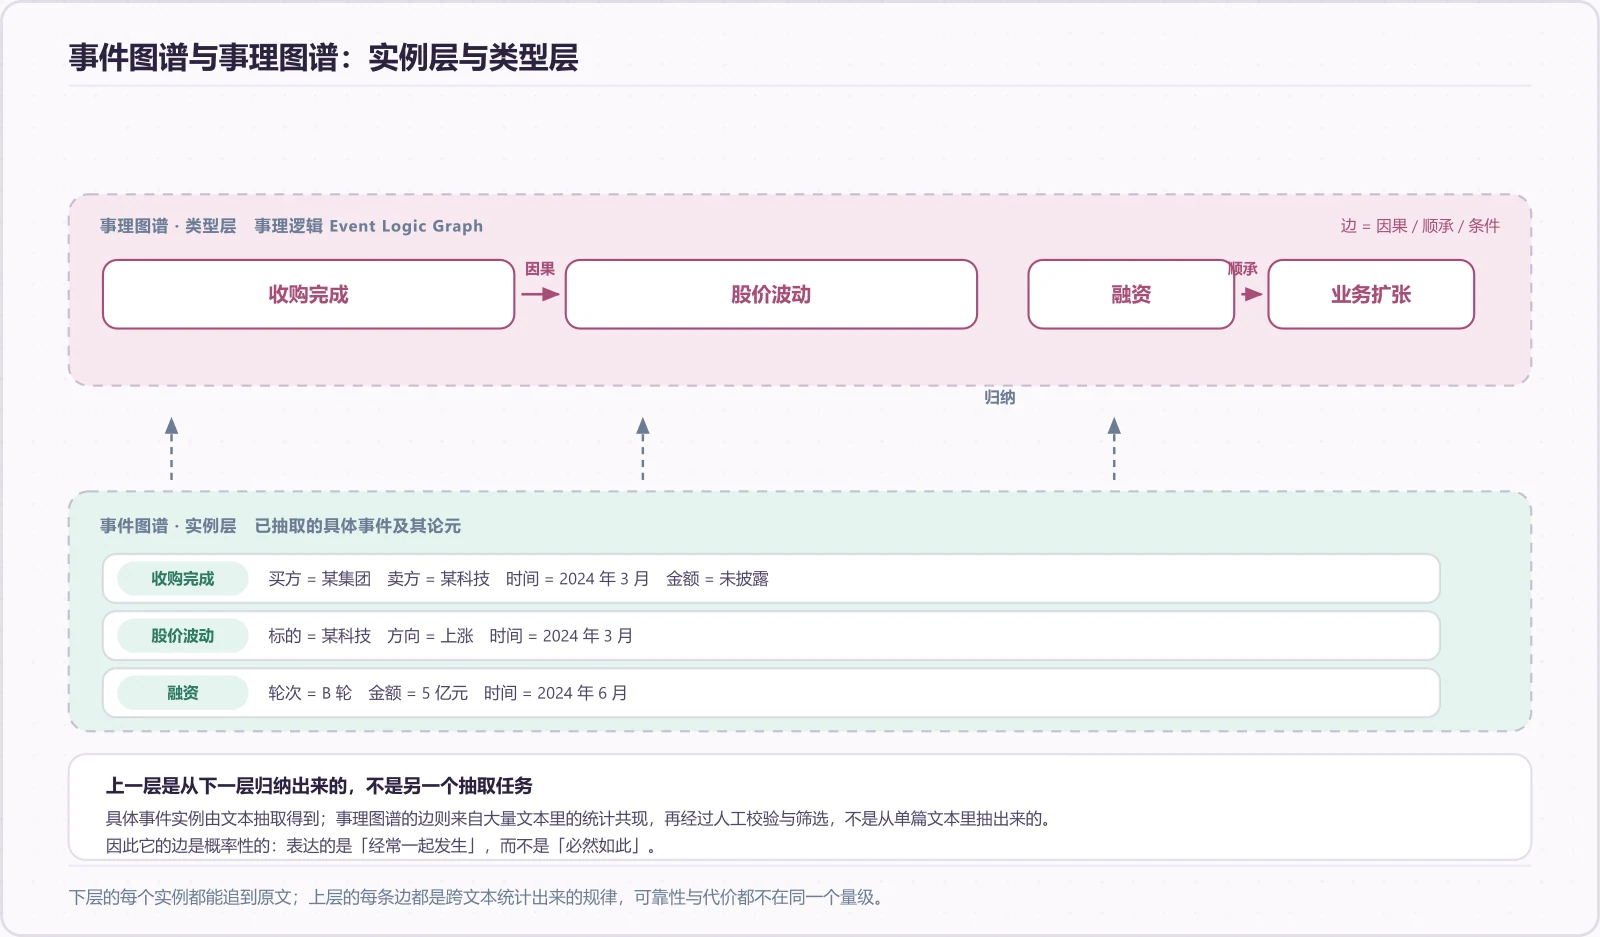
再往下一层是事理图谱(Event Evolutionary Graph, EEG):描述事件之间顺承、因果关系的事理演化逻辑有向有环图,节点表示抽象、泛化的事件,有向边表示事件之间的顺承与因果。它本质上是一个事理逻辑知识库。两者容易混淆,对比表如下。
| 对比项 | 事理图谱 | 知识图谱 |
|---|---|---|
| 研究对象 | 谓词性事件及其关系 | 名词性实体及其关系 |
| 组织形式 | 有向有环图 | 有向有环图 |
| 知识形式 | 事理逻辑关系、概率转移信息 | 实体属性和关系 |
| 知识属性 | 事件间的演化关系大多是不确定的 | 大部分实体关系是确定的 |
组织形式的相同与知识属性的相反,是这张表里最值得注意的两格。知识图谱里 A 是 B 的父亲、B 是 C 的父亲,不会有人期望 C 又变成 A 的父亲;但「货币超发」这类场景画出来的,就是一张环状事理图谱。事件可以转圈,实体的父子关系不行。
三、标注体系与数据集
把事件抽取的评测历史摊开看一遍,能理清「为什么 ACE 成了事实标准」。
| 评测 | 全称 | 组织者 | 时间 | 内容 |
|---|---|---|---|---|
| MUC | Message Understanding Conference | DARPA | 1987–1997 | 抽取指定事件,包括参与事件的各个实体、属性和关系 |
| TDT | Topic Detection and Tracking | DARPA | 1998–2004 | 把文本切割为不同新闻报道,监控新事件报道,把同一话题下的分散报道按某种结构组织起来;有 240 个 Topic |
| ACE / KBP | Automatic Content Extraction | NIST | ACE:2000–2008;KBP:2014–2017 | 从指定源语言中发现特定类型事件,识别相关信息填入预设事件模板;ACE 共 8 个大类、33 个小类事件 |
ACE 的「填模板」思路是整套方法论的起点:事件类型先定义好,每个类型有固定角色槽位,抽取就是往槽里填。
中文这边要重点看 DuEE,全称 baiDu Event Extraction dataset,被称为「业界已知规模最大的中文事件抽取数据集」,来自 2020 年语言与智能技术竞赛,论文是 DuEE: A Large-scale Dataset for Chinese Event Extraction in Real-world Scenarios,NLPCC 2020。
| 数据集 | 事件数 | 事件类型数 |
|---|---|---|
| ACE 2005 | 2.5K | 33 |
| KBP 2017 | 2.5K | 18 |
| DuEE 1.0 | 20K | 65 |
把「事件类型数」和「事件数」并排看,比只看总量有用。ACE 2005 用 33 个类型摊 2.5K 个事件,平均每类不到 80 个。这就是事件抽取特别吃数据、也特别容易过拟合到头部类型的原因。
四、方法脉络:从模板到联合模型
方法大致分四类:基于模板和规则(定义语义框架和短语模式,表示特定领域事件的抽取模式)、基于机器学习(当作传统分类任务做,依赖依存分析、句法分析、词性标注等工具)、基于深度学习(分 Pipeline 与 Joint Model 两条)、基于知识库(利用外部资源做远程监督标注)。
Pipeline 把四个子任务串成流水线:触发词识别 → 触发词分类 → 元素识别 → 元素角色分类。Joint Model 想把这四步放进一个模型里一起做,它的优势可以收成三条:
- 避免误差累积传播导致模型性能下降
- 用一个模型同时抽取所有事件信息
- 用从整体结构中学到的全局特征,提升对局部信息的预测能力
| 代表工作 | 路线 | 核心做法 | 公开成绩(ACE 2005) |
|---|---|---|---|
| DMCNN(Chen et al. 2015) | Pipeline | 词汇级 + 句子级特征;按元素与触发词切分 feature map 的三段动态多池化 | 触发词分类 F1 69.1,论元角色 F1 53.5 |
| JRNN(Nguyen et al. 2016) | Joint | 双层双向 RNN 编码;用记忆向量/矩阵编码 trigger 与 role 间依赖,迭代预测 | 触发词分类 F1 69.3,论元角色 F1 55.4 |
| FrameNet 扩数据(Liu et al. 2016) | 知识库 | ACE 训基础 ED 模型 → 判 FrameNet 句子 → PSL 全局推断 → 反哺训练数据 | 论元识别 F1 70.7(基线 DMCNN 69.1) |
DMCNN:为什么需要句子级特征
两个句子就能说明这件事:S1: Obama beats McCain. 是 Elect 事件,S2: Tyson beats his opponent. 是 Attack 事件。同样是 beats,事件类型不同,光看词本身不够。
DMCNN 的句子级特征有三类:
| 特征 | 含义 |
|---|---|
| 上下文特征(WF) | 论元候选词的上下文 |
| 位置特征(PF) | 当前词与待预测类型候选词的相对距离 |
| 事件类型特征(EF) | 把触发词的事件类型编码成特征,辅助元素识别与分类 |
Dynamic Multi-Pooling 则针对池化方式:传统 max pooling 对整个 feature map 做一次 max,dynamic pooling 把每个 feature map 按候选元素和触发词的位置切成三块再分别取 max,让三区的特征不互相淹没。
JRNN:把角色依赖记进记忆里
JRNN 的预测阶段是这一系列方法里结构最完整的设计。它为触发词建记忆向量 、为事件元素建二元记忆矩阵 ,用来编码 trigger labels 与 argument roles 之间的依赖,两者初始都置 0,在预测过程中不断更新。
迭代过程是:对当前词 做 Trigger Prediction,再针对它给每个实体做 Argument Role Prediction,每轮用上一轮的结果更新记忆,没命中的位置置为 "other"。这个做法的实质,是把「哪个角色跟着哪个触发词出现」当成可学习的结构先验,而不是靠流水线在模型外部硬拼。
知识库线:用 FrameNet 扩训练数据
FrameNet 是语言学家定义的语义框架资源:一个 Frame 描述事件、关系或实体的类型及其参与者,同时也是词法数据库,含一千多个框架、一万多个词法单元(Lexical Unit, LU),层级里 LU 对应 Trigger、FEs 对应 Arguments。
这条路线的方法分四步:用 ACE 语料训一个基础事件检测模型;用它给 FrameNet 的句子做初始判断;基于三条软约束假设(Same frame same event、Related frame same event、Same LU same event)用 PSL(Probabilistic Soft Logic,概率软逻辑)做全局推断;最后用扩充后的数据重训,扩展 ACE 训练集。
论元识别 F1 从 69.1 提到 70.7。这个数字的重点不在涨幅本身,而在召回率上有 8.7 个点的提升:补召回正是扩数据这类做法的典型收益。
五、难点
这些坑散在各个环节里,没有集中在同一处。
触发词歧义
beats 就是最小例子,同一个词在 Elect 和 Attack 两种类型下都是触发词。DMCNN 加句子级特征、加动态多池化,本质都是在给「同一个词的不同事件类型」提供区分信号。
候选事件组合爆炸
一个关键事实:不同实体组合、或其中任何一个实体的内容改变,都会形成新的候选事件,导致候选事件数量呈指数级增长;但实际公告文档里一篇包含的事件不会超过 5 个。理论空间爆炸,真实分布极稀疏,这是设计任何方案的前提,直接做「候选事件二分类」必然被负例淹没。
论元跨句与上下文
工程答案是上下文嵌入:把上下文信息编码进句子向量之后,模型性能最高提升 14.1 个百分点,最少也提升 4.8 个百分点,整体提升 6.7 个百分点。
事件关系:顺承与因果
顺承关系指两个事件在时间上先后发生的偏序关系,英语体系里又称时序关系。顺承事件对之间存在介于 0 到 1 之间的转移概率,例子是「吃过午饭后,小明到前台买单,然后离开了餐馆。」
因果关系在满足顺承时序约束的基础上强调前因后果,因果关系是顺承关系的子集,因果事件对之间存在介于 0 到 1 之间的因果强度值,例子是「核泄漏引起了严重的海洋污染。」
顺承是因果的超集,这一条在工程上很好用:因果识别可以只在顺承候选对上做,省掉一大截标注。
中文的特殊问题
中文事件抽取走字粒度,事件元素抽取用 BERT + CRF 以字符为单位做序列标注。金融领域的系统本身就是这个答案,理由也直接:中文触发词跨词边界的情况多,先分词再标注会引入额外误差。
六、金融领域的落地:一份完整的工程答案
金融领域的事件抽取系统实现里,每个抽象概念都对应到了具体模块。系统分五块:数据采集、知识库构建、数据标注、模型训练与评估、在线服务。抽取目标是五种上市公司公告事件:股权质押、回购、冻结、增持和减持。
事件本体
事件本体是知识库的骨架,构建遵循三条原则:一致性、可扩展性、最小编码偏差。本体里的角色分核心角色与非核心角色,核心角色表示构成一个事件所必须的信息,缺任意一个核心角色都无法构成一个完整的事件。
| 事件类型 | 核心角色(名/类型) | 非核心角色(名/类型) |
|---|---|---|
| 股权质押 (EquityPledge, EP) | EquityHolder 股权质押方(人名/机构名)、Pledgee 股权质权方(机构名) | StartDate 开始日期、EndDate 截止日期、ReleasedDate 解除质押日期(日期);TotalPledgedShares 总计质押股票数量、TotalHoldingShares 总计持有股票数量(数量);TotalHoldingRatio 总计质押股票比例(百分比) |
| 股权冻结 (EquityFreeze, EF) | EquityHolder 股权持有方(人名/机构名)、LegalInstitution 冻结机构(机构名) | StartDate 开始日期、EndDate 截止日期、UnfrozeDate 解冻日期(日期) |
知识库构建:Fonduer 的三个阶段
知识库构建用 Fonduer,结合机器学习、弱监督学习、规则和词典,从公告文档中抽结构化事件。整个流程分三个阶段。
| 阶段 | 做什么 | 关键概念 |
|---|---|---|
| 一 | 把 PDF 转成 Fonduer 的 Data Model | 有向无环图(DAG),根节点是文档,按章节切分,章节含文本和表格(表格可切出行、列和标题属性),这个结构允许从文档的不同上下文抽出事件元素并组成候选事件 |
| 二 | 抽出指定类型实体,按本体组合成候选事件,再滤掉负例 | 匹配器(正则、字典过滤或自建规则)负责抽实体;过滤器负责筛负例,规则是必须含核心类型实体、实体须按一定顺序出现 |
| 三 | 为每个候选事件生成多模态特征(文本、表格、视觉),走弱监督分类 | 标记函数(把候选事件标成正例、负例或放弃标注的数据编程范式)提供弱监督标注,再经「模型学 → 小样本测试 → 调标记函数」迭代到可用 |
这套做法还改进了远程监督的对齐方式:用定向链接把抽出的知识再回标到原文形成训练语料,拿高置信度的结果反过来当弱标注。
抽取模型
抽取模型基于 Joint Model,由事件元素抽取和事件类型检测两部分组成,共享输入层和 BERT 层,用超参数 调节两个任务的损失在整体损失中的比重。
| 子任务 | 形式 | 做法 |
|---|---|---|
| 事件元素抽取 | 序列标注 | 用 BIO 格式,BERT 给字符语义向量,前馈网络映射到标签维度,CRF 解码 |
| 事件类型检测 | 分类 | 多层 Transformer 编码器把上下文嵌进句子向量,并为每种事件类型定义一个二分类模型 |
规模与在线服务
五种事件类型合计 31748 篇文档、46960 个结构化事件,分布如下。
| 事件类型 | 文档数 | 事件数 |
|---|---|---|
| 股权质押 | 15533 | 24737 |
| 股权增持 | 5787 | 8449 |
| 股权减持 | 5593 | 7343 |
| 股权回购 | 3667 | 4531 |
| 股权冻结 | 1168 | 1900 |
在线服务用 Django 搭建,支持批量发送金融公告 PDF。下面这段 JSON 是系统返回结果的抽取整理:
{
  "doc_id": "SZ001696_2013-07-12",
  "events": {
    "EquityRepurchase": [
      {
        "key_sen_id": 5,
        "key_sentence": "截止2013年7月11日,公司回购股数量为23752504股,占公司总股本的比例为2.09%,成交的最高价为5.28元/股,最低价为4.40元/股。",
        "event_roles": {
          "CompanyName": "重庆宗申动力机械股份有限公司",
          "HighestTradingPrice": "5.28元",
          "LowestTradingPrice": "4.40元",
          "RepurchasedShares": "23752504股"
        }
      }
    ]
  }
}
key_sentence 按上下文标点拼接成一行;ClosingDate、RepurchaseAmount 两个字段存在,但取值无法辨认,此处省略未补。
七、事理图谱怎么造出来、用在哪
构建流水线
数据清洗 → NLP 预处理 → 事件抽取和泛化 → 生成候选事件对;然后分三支:顺承关系识别、顺承方向识别、因果关系识别;再接转移概率计算。
因果对的抽取走规则法:用因果触发词构造填充模板做正则匹配,得到 cause 和 effect 子句,模板形如 (+) (导致|引起|造成) (+) (下跌|上涨);再对两个子句分词、词性标注、做词性过滤,取动词、名词、形容词构成的句子主干作为最终的 cause 和 effect。实例有「中兴通讯利润下滑引发股价大跌」「双汇并购史密斯菲尔德消息使得双汇发展股价大涨」。
财经新闻里的因果有两种形态:显式因果(带关联词),如「塑化剂事件导致白酒股大跌」;隐式因果(无关联词),如「百度 Q2 财报:净利同比增 82.9%,股价盘后上涨 7%」。除因果之外还有大量顺承关系,如「停牌了近半个月的科大讯飞(002230.SZ)复牌,股价开盘即涨停」。
产出规模
数据来自腾讯、网易、和讯等网站的财经新闻文本,以及人民日报、中国青年报等开放领域新闻文本。关键技术含事件抽取、事件间顺承和因果关系识别、事件转移概率计算、事件类别识别和事件要素提取。
| 指标 | 数值 |
|---|---|
| 文档 | 1165 万篇 |
| 事件节点 | 138 万 |
| 因果关系对 | 141 万 |
| 因果事件关系抽取 F1 | 72.6%(对随机选取的 1000 条因果关系做人工评价) |
形态上有三种:「看电影」场景下的链状、「结婚」场景下的树状、「货币超发」场景下的环状。
应用与前沿
应用场景有三类:智能对话系统(对话中出现事件 A 时,回复里可提及 A 的前提或后继事件)、消费意图识别与推荐系统(「去旅行」「爬山」这类消费意图显著事件能触发一系列后续消费事件)、常识推理。
研究前沿有两条。统计脚本学习关注事件链条抽取、事件预测和事件间转移概率建模,经常用一个十分抽象的动词或依存关系表示事件。事件间时序因果关系识别关注如何识别两个事件之间的时序、因果关系及关系方向。
八、评测与工程建议
指标这块没有单独开一节的通行讲解,但可以反推出几条判断。
别只看整体 F1
金融系统那张对比表里,五类事件的 F1 跨度很大:最高的股权回购(With-Context)到 87.0,最低的股权增持只有 54.8。只看 Micro 66.7 会误判系统的可用性。
分阶段看指标
DMCNN 和 JRNN 的触发词分类 F1 是 69.1 / 69.3,几乎打平;论元角色 F1 是 53.5 / 55.4,拉开 1.9 个点。论元角色才是瓶颈,因为它依赖触发词已经判对。
核心角色缺失等于事件不存在
拿不到 EquityHolder 和 Pledgee,就不该算作抽对了的股权质押事件,哪怕其他非核心角色全对。这条口径需要在评测前定下来,否则指标会虚高。
正负例极度不均衡是设计前提
候选事件指数级增长,而真实事件一篇文档不超过 5 个。这不是数据异常,是任务本身的分布特征,采样策略、损失函数和阈值都要围绕它设计。
工程顺序上的几条建议
- 先把事件本体定死。 核心角色是哪几个、类型和值域是什么,比选模型重要得多,后面所有标注、过滤、评测口径都挂在这上面。
- 数据不够就走知识库线。 ACE 2005 每类不到 80 个事件,FrameNet 那条路线(外部语义框架资源 + PSL 全局推断)扩的正是召回。
- 中文走字粒度。 按字符做序列标注,避免分词误差叠加到触发词与论元边界上。
- 不必急着上大模型。 经典方法在 46960 个结构化事件的规模上已经跑通,而且可解释、能定位错误、能算置信度。在有三万篇标注文档的垂直领域,把这条基线打满更划算。
- 服务层要解耦。 用 Django 把模型包成服务、支持批量 PDF 输入,这一步是「抽取模型」变成「事件知识库」的必经环节。
九、小结
事件抽取的价值在于它补上了知识图谱缺失的时间维度与动作维度。代价是链条变长、标注变贵、评测变复杂:四个子任务串起来,任何一步出错都会传到最终结果,而核心角色的缺失又会让整个事件实例失去意义。
落到工程上,判断顺序是:先定事件本体,再定标注与评测口径,最后才选模型。顺序反过来,通常会得到一批指标看着不错、但无法用于下游查询的事件实例。