第 04 篇讲的是找出文本里的实体,这一篇讲实体之间那根边怎么抽出来。
关系抽取(Relation Extraction, RE)的引子,是这么一句:
Opportunity and Curiosity find similar rocks on Mars.
从这一句要读出这么一张小图:Opportunity 和 Curiosity 是火星车(Mars rover,即 is_a),它们在那里做探索(explorer_of),而这一切发生在一个位于太阳系的行星上(located_on)。
实体识别回答「谁是实体」,关系抽取回答「它们之间是什么边」。一篇新闻里出现的实体通常有几十个,而有价值的关系可能只有几条,所以关系抽取的难点不只是识别出边,还包括在大量无关实体对里判断哪几对有关系。
一、先把任务说清楚
输入输出与形式化
输入输出很朴素:给一段标好实体(或先跑一遍 NER)的文本和候选实体对 (e1, e2),输出两者的语义关系类型,通常还要求方向。
所以主流做法是把二元关系抽取形式化成分类问题:抽特征向量后学一个分类函数 f。有一种说法很准,「将二元关系抽取视为分类问题」,训练时 y 取 {−1, 1},多分类无非把 y 扩成关系类型集合。这个形式化决定了后面几乎所有方法的骨架:特征怎么抽、分类器怎么选、类别空间怎么定。
关系类型体系从哪来
关系类型不是凭空定的,它有两类语义来源:概念间的关系「主要是关于世界的知识,可以从文本中发现」;名词间的关系「主要关注文本所表达的事件或者形势,可以通过知识库信息进行发现」。
落到工程上就是两套标签体系。
| 体系 | 类型从哪来 | 例子 | 代价 |
|---|---|---|---|
| 封闭体系 | 本体 / 知识库预先定义关系类型,标注时选一个 | MUC、ACE 的那几类,Freebase 里的关系谓词 | 好处是能接下游推理,坏处是覆盖不全、域外就废 |
| 开放体系 | 开放式关系抽取(Open IE)「没有预先指定的关系列表或关系类型」,学的是关系表达本身 | 词性序列(POS)、句法树路径、高频词序列都能当模式 | 抽取结果很难映射到知识库中 |
标注口径的变化:从 SemEval 看
从 SemEval 的两届任务上,能看清标注口径是怎么变的。
| 任务 | 标注形式 | 决策内容 |
|---|---|---|
| Task 4 | 实体用 <e1>...</e1>、<e2>...</e2> 标出 |
参数手工用 WordNet 消歧,系统给每对实体打 true/false |
| Task 8 | 变成多类别数据集,候选实体仍然给 | 要决策实体在关系里的槽位,WordNet sense 和 query 都不再提供 |
两届任务之间发生的是从「给定关系判定成立性」到「给定实体对预测关系」,分数的含义完全不同。读论文里的 F1 时如果不确认这一点,跨论文的数字就没法比。
二、关系的语言学清单:为什么标签体系到今天还很乱
关系类型体系混乱的根源在语言学这一层,它有一份很长的枚举史。
| 工作 | 关系数量 | 结构 |
|---|---|---|
| 卡萨格兰德和海尔 | 13 种 | 让人给单词下定义后抽出 |
| 查芬和赫尔曼 | 31 种 | 分组后得到 5 个粗粒度类别 |
| Warren | 六大语义关系 | 从布朗语料库做出四级关系层次 |
| Nastase & Szpakowicz | 31 种 | 两级层次 |
| Barker & Szpakowicz | 20 种 | — |
| Tratz & Hovy | 10 个类别中的 43 种 | 靠迭代众包最大化标注一致性 |
| 生物医学领域的罗萨里奥 | 18 种 | 最初 38 种,后收敛到 18 种 |
这份清单的共性很清楚:定位、占有、目的这几类关系在所有体系里都出现,基本上覆盖了相同的语义空间,但是区分该空间的确切方式不同。Downing 则反过来认为这种有限枚举「都是徒劳的」。
复合名词的三个性质最能说明难度:难解读(taxi driver 是「开出租的司机」)、难忽略(涵盖路透社语料中 4% 的词汇)、高产到无法入词典(60% 只在 BNC 里出现一次)。
这三个性质合起来给出一个判断:关系抽取一半的难度不在模型,而在你选了一个什么样的关系集合。选得细,标注一致性立刻下降;选得粗,抽出来的边接不上下游推理。
三、特征工程时代的家底
神经方法流行之前的套路是「抽特征 + 训分类器」。特征可以分成两族。
实体特征分三层:
- 基本实体特征(参数字符串值、词形化 / 词干化的单词),信息量往往够但很稀疏
- 背景实体特征(语法角色、语义类别、ACE entity types、WordNet 这类资源),能压稀疏,代价是要人工资源
- 再往上是聚类得到的语义类别(Brown clusters、Clustering By Committee、LDA)和分布表示
关系特征分两类:
- 基本的有「两个参数之间的单词」「参数特定窗口或一侧的单词」「链接参数的依赖路径」「完整的依赖图」「最小支配子树」
- 背景关系特征编码「实体通常如何交互」,Nakov & Hearst 从 web 上抽含参数的动词、介词、协调词(
X that * Y、X * Y这类模式),Turney 挖的是Y * causes X(Cause)和Y in * early X(Temporal)
算法上有三条路:
| 路线 | 做法 | 适合什么 |
|---|---|---|
| 特征向量法 | 朴素贝叶斯、SVM、最大熵 | 特征能枚举成固定长度的向量 |
| 核方法 | 关系特征结构复杂,可在高维空间直接算相似度而不枚举维度,句法树、依赖路径、有向无环图都有对应核 | 结构化特征,如句法树 |
| 序列标注 | HMM/MEMM/CRF 用于论元识别;在某些特殊的情况下,关系抽取可以退化为序列标注问题 | 人物传记类文章主要实体已知,只要找其他实体与它的关系 |
早期基线里两个数字值得记:Kambhatla 用最大熵在 ACE RDC2003 的 24 个子类关系上拿到 F 值 52.8%,结论是「多个层次的语言学特征能够提升关系抽取的效果」;Che 在 ACE RDC2004 上比较 Winnow 和 SVM,性能相当。
特征这套家底可以用一张表概括,每一行都对应一种代价。
| 表示 / 方法 | 主要思想 | 主要代价 |
|---|---|---|
| 实体特征 | 参数字符串、词形 / 词干;语法角色、语义类别、WordNet/ACE 类型 | 前者稀疏,后者要人工资源 |
| 分布与关系语义表示 | 聚合词在大语料中的交互;借用语义网络 / 本体的概念 | 混含义;需要保证词义无歧义 |
| 基本关系特征 | 中间词、窗口词、依赖路径、依赖图、最小支配子树 | 结构复杂,难以枚举进向量 |
| 核方法 | 在高维空间算相似度 | 核的选择与计算开销本身就是负担 |
四、四种范式的价格表
先看那个朴素的二选一:监督学习「表现很好」,但「需要大量的标记数据和特征表示」;无监督学习「可扩展,适用于开放式信息提取」,但「表现比较差」。折中是弱监督,它出现的两个原因说得很直白:减少构建标记数据所需的人力,充分利用容易获得的无标记数据。
这张价格表把四种范式放在一起对照。
| 范式 | 标注需求 | 主要噪声来源 | 典型代价 |
|---|---|---|---|
| 模板 / 模式匹配 | 无(人工写规则) | 模式设计者的覆盖盲区 | 高准确率、低召回、难维护、可移植性差 |
| Bootstrapping | 极少量种子 | 语义漂移、上下文依赖、细粒度关系混淆 | 易漂移,需限轮数 / 打分 / 类型约束 |
| 远程监督 | 只要知识库 + 无标注文本 | 假设过强导致的假阳性 | 规模大、可自动,标签噪声重 |
| 全监督 | 大量人工标注 | 标注一致性、领域漂移 | 效果最好,但代价是标注与特征表示 |
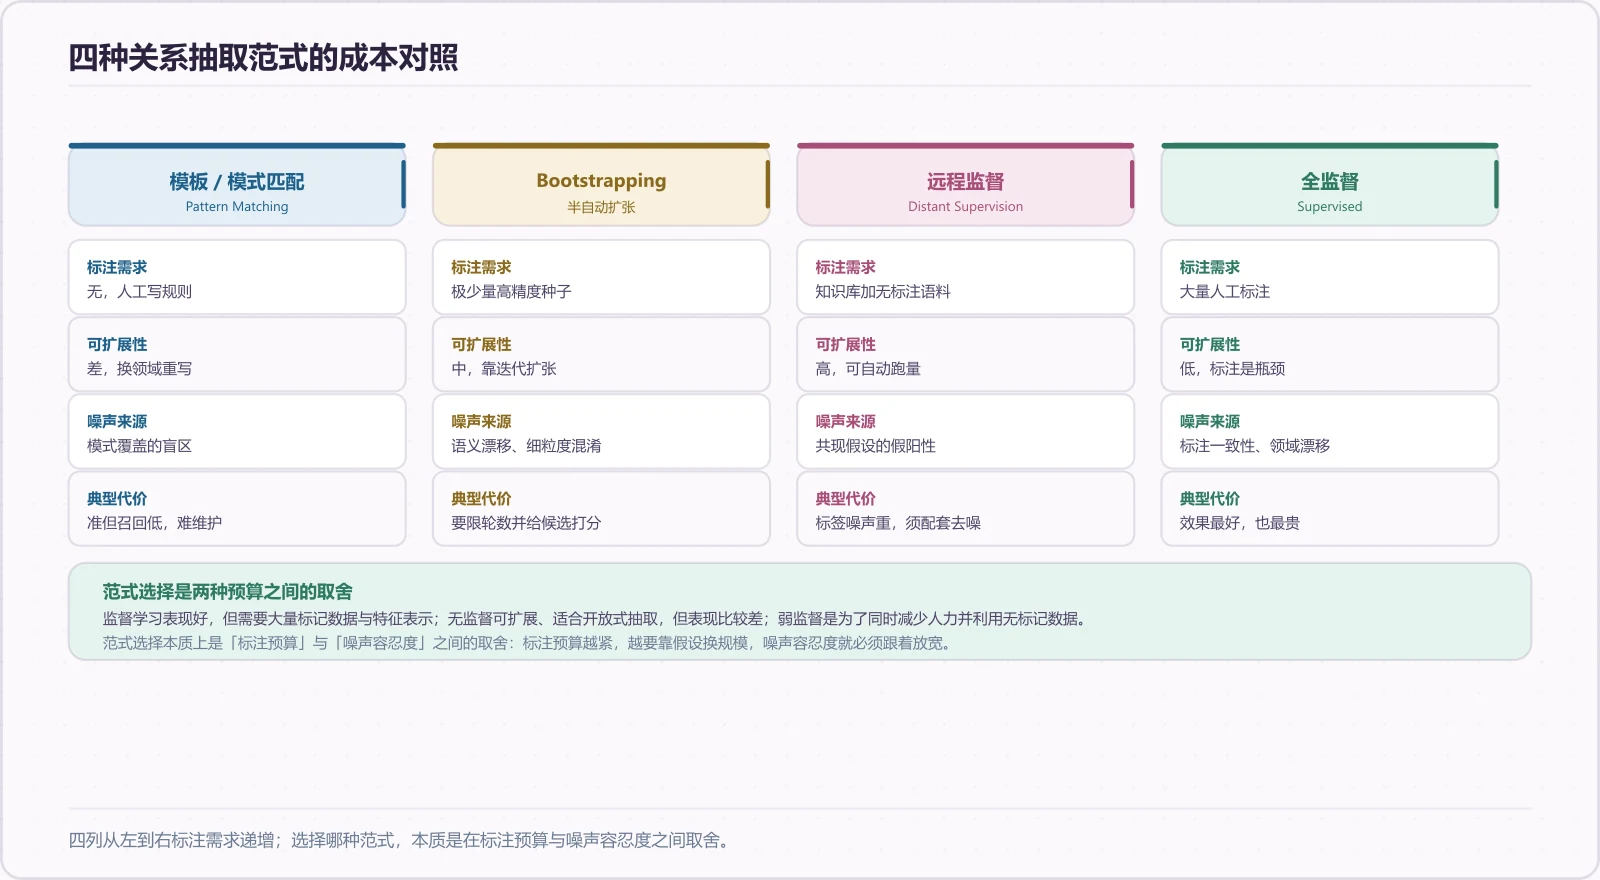
下面按这张表逐行展开。
基于模板
关系模式是一个表达式,与文本片段匹配时能标识出关系实例,可以是词典项、通配符、词性、句法关系,也可以是正则里的灵活规则。
Hearst (1992) 的模式清单抽 is-a,准确率高但召回率低,且只覆盖 is-a;后来被扩展到 part-of(Berland & Charniak)和蛋白互作(N1 inhibits N2、inhibition of N2 by N1)。召回率有多低有个具体数字:Hearst 只在格罗里尔的美国学术百科全书上验证,那个数据集有 860 万词,但「仅仅抽取出了 152 个实例」。高准确率就是这么换来的。
这一路的账是:优在准确率、可定制、小数据集上构建简单;缺在低召回、要为每条关系定义 pattern、难维护、可移植性差。
骨架大概是这样,模式清单是现成的,代码是示意写法:
# Hearst 风格 is-a 模式:三条规则,符合"高准确率、低召回"的定位
PATTERNS = [
    r"(?P<h>[\w\s]+?) such as (?P<t>[\w\s,]+)",
    r"such (?P<h>[\w\s]+?) as (?P<t>[\w\s,]+)",
    r"(?P<t>[\w\s]+?),? (?:and|or) other (?P<h>[\w\s]+)",
]
def extract(text):
    for p in PATTERNS:
        for m in re.finditer(p, text):
            for t in re.split(r",| or | and ", m.group("t")):
                if t.strip():
                    yield (t.strip(), "is-a", m.group("h").strip())
Bootstrapping
给定少量高精度种子(模式 P 或已知实例 R,如 cat-animal、car-vehicle),反复做「新模式 ↔ 新实例」的扩张。主要难点是语义漂移(semantic drift),它有三类短板。
| 短板 | 具体表现 |
|---|---|
| 对上下文依赖的关系不友好 | 报纸里这个月「Barcelona defeated Real Madrid」,几个月后可能反过来 |
| 只对特定关系表现好 | 如 birthdate |
| 无法区分细粒度关系 | Part-Whole 底下的 Component-Integral_Object、Member-Collection 等可能共享同一批模式 |
压漂移的手段有几种:限制迭代次数、每轮只加少量模式与实例、用语义类型约束(SNOWBALL 的 <Organization>'s headquarters in <Location>)、参数类型检查,以及给候选打分只留高分。打分函数有几个代表:
- Curran 等的特异性评分 specificity(p) = −log(Pr(X ∈ MD(p)))
- Agichtein & Gravano 基于准确率的置信度
- Pantel & Pennacchiotti 按模式与关系可靠性定义的置信度
弱监督的图与协同
Chen 等 2006 年在 ACL 提出的标注传播(Label Propagation),依据是「特征集合相似且语法结构相似的关系实例倾向于属于同一种关系类型」;Cvitas 2011 的协同学习(Co-learning)则是选两个分类器、用相互独立的特征训练,各自挑高置信度实例加进对方训练集。
完全无监督那条路
起因是「有监督和半监督方法需要事先确定关系类型,而大规模语料中人们往往无法预知所有关系类型」。一般过程是先聚类实体对、再用代表性词语给簇打标记。
| 工作 | 做法 |
|---|---|
| Hasegawa 2004(ACL) | 最早提出,后续方法多在此基础上改进 |
| Shinyama 2006 | 用来源分类加二次聚类 |
| Quan 2014 | 用多项式核做模式聚类识别生物医学的交互词 |
| URES | 非聚类的网页抽取系统 |
它的优点与缺点在前面的二选一里已经说完了:可扩展、适合开放式抽取,但表现比较差。
远程监督
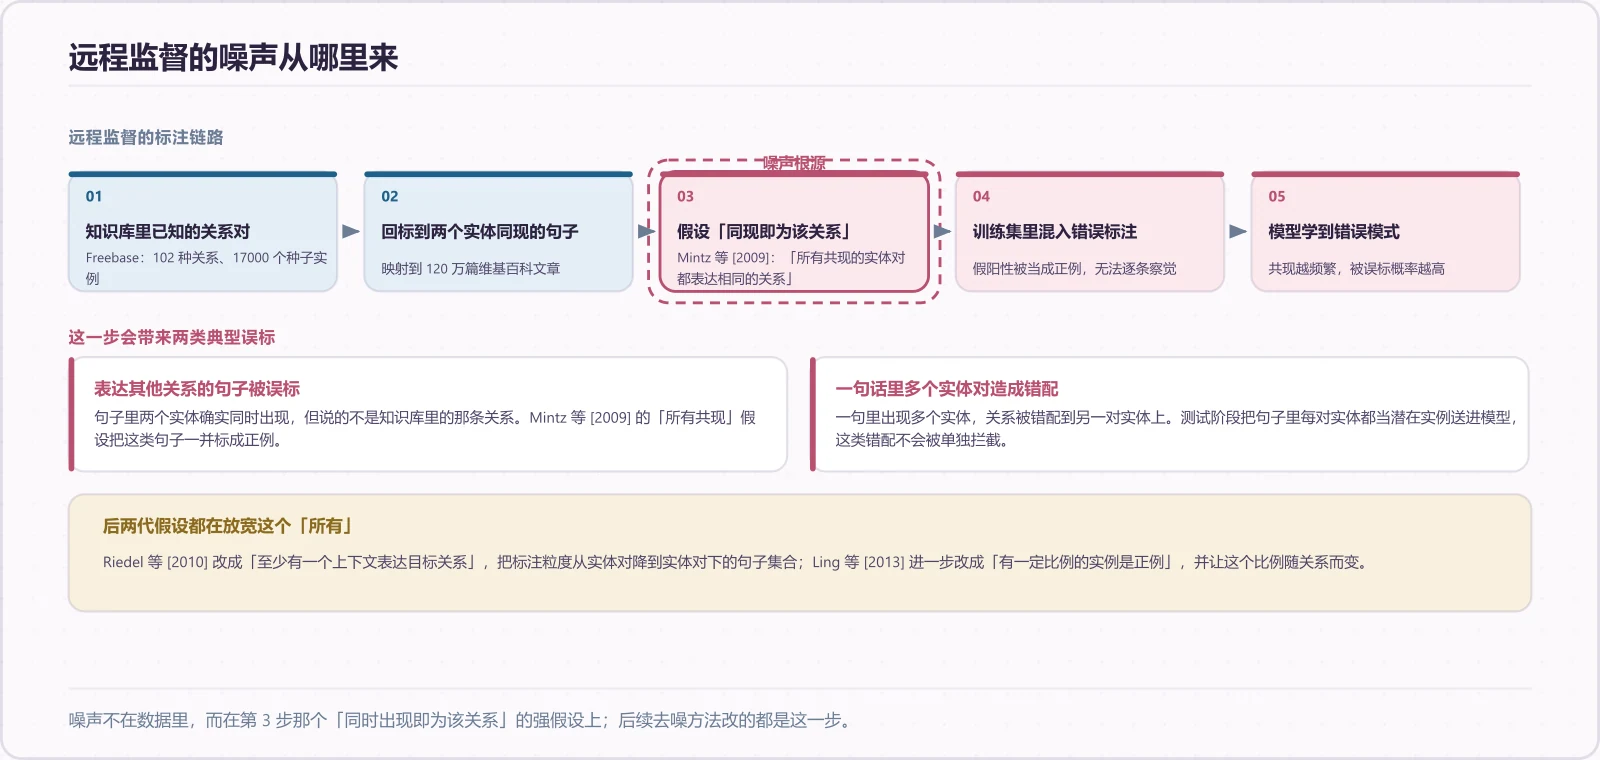
远程监督(distant supervision)是把外部知识库当「免费标注员」。Mintz 等的规模很直观:Freebase 的 102 种关系、17000 个种子实例,映射到当时 120 万篇维基百科文章,最终抽出 180 万个实例、连接 94 万个实体。
流程分两个阶段:
- 训练阶段用 NER 标 person / organization / location,对 Freebase 中出现的实体对提特征、训一个多类别逻辑回归
- 测试阶段把句子里出现的每对实体都当潜在关系实例送进模型
它的标签噪声来自哪里,是下一节的整段内容。
五、远程监督的噪声到底从哪来
三代假设放在一起看,这一段最该背下来。
| 代际 | 假设的原文 | 相对上一代改了什么 |
|---|---|---|
| Mintz 等 [2009] | 「假设:所有共现的实体对都表达相同的关系。」 | 起点 |
| Riedel 等 [2010] | 「假设至少有一个上下文表达目标关系(而不是所有)。」 | 把「所有」放宽为「至少一个」 |
| Ling 等 [2013] | 假设所有上下文中「有一定比例的实例是正例」,且这个比例因关系而异 | 把「至少一个」放宽为「一定比例」 |
噪声就藏在第一版的「所有」两个字里。知识库说 (e1, r, e2) 成立,语料里凡是同一对 e1、e2 同句出现的地方都被打上 r,可同一对实体在不同句子里聊的根本不是同一件事,或者干脆只是偶然共现。
一个可以预期的规律是:一对实体在语料里同现次数越多,被误标的概率越高。这正是 PCNN 一类模型要处理的场景。而 PCNN 与多实例学习在常见的方法清单里并不出现,只在 Riedel 的 at-least-one 假设这一层有对应思想。
第二、三代假设是对「所有」的修正。Riedel 的「至少有一个」把标注粒度从实体对降到「实体对下的句子集合」;Ling 等做生物学知识库的 meronym 抽取,扩展 Hoffmann 等人的图形模型以强制百分比约束,用感知器训练,再用交叉验证加网格搜索给每个关系找最佳百分比。
去噪的三个着力点
今天工程上常说的 PCNN 那一套,对应的零件可以按「改哪里」分成三组。
把表示做对。 Zhou 2016(ACL)的 Attention-Based BiLSTM 共 5 层,Attention 层「生成一个权重向量……使每一次迭代中的词汇级特征合并为句子级特征」。
He 2018(AAAI,阿里巴巴)的 Syntax-aware Entity Embedding 用依存树上的 Tree-GRU 生成实体在句级的表示(「能够更好地表达出长距离的信息」),再用子节点注意力 ATTCE 与句级实体表示注意力 ATTEE「减轻句法错误和错误标注的负面影响」。
把外部信息拿进来。 Vashishth 2018(EMNLP)的 RESIDE 用含关系别名的侧信息改进远程监督神经抽取。
把实例选择做对。 Takanobu 2019(AAAI)的层次强化学习框架针对两个问题:「大部分现有方法在实体被识别后才决策关系类型」、把两者割裂成两个子任务,且「很多和关系无关的实体会带来噪声」;结构是 high-level RL 做关系检测、low-level RL 做实体抽取。Feng 2018(AAAI)的《Reinforcement Learning for Relation Classification from Noisy Data》能看到的只有标题和框架图。
强化学习在这里扮演的是实例选择器:它决定哪些句子被用来更新关系分类器,也就决定了噪声被放大还是被压掉。
六、神经方法与「关系分类」这条支线
词嵌入那一段(CBOW、skip-gram、LSA/LDA/PCA、显式表示)里有两句细节值得记:CBOW 相对 NNLM 的简化在于「模型复杂性主要来自 non-linear hidden layer,因此去掉了它」,且「linear layer 被所有 words 共享」;Levy & Goldberg 2014 的依存词嵌入里,Words 是局部的(topical),Dependencies 是功能的(functional)。
关系抽取这一侧的代表模型按时间排下来是这样。
| 模型 / 方法 | 表示 | 聚合方式 | 要点 |
|---|---|---|---|
| Socher 2012 | 递归矩阵向量空间(MV-RNN) | 语义组合 | 「为解析树中的每个节点分配了一个向量和一个矩阵:向量捕获成分的内在意义,矩阵捕获它如何改变相邻单词或短语的意义」 |
| CNN [Zeng 2014] | 词向量 + 位置向量(到 e1/e2 距离) | 卷积 + 池化 | 窗口大小 3 捕获局部上下文 |
| CNN + ranking loss [dos Santos 2015] | 同 Zeng | Max Pooling | 换掉 softmax + 交叉熵,改 margin based 的 ranking loss;全连接得到类别 score(Wclasses 每一列可视作 label 的 embedding) |
| BiLSTM + Attention [Zhou 2016] | 词嵌入 → BiLSTM 高级特征 | Attention 权重合并为句级特征 | 句级特征做 softmax 分类 |
| Tree-GRU [He 2018] | 依存树上的实体表示 | ATTCE + ATTEE 双层注意力 | 表达长距离信息,缓解句法错误与错标 |
| RESIDE [Vashishth 2018] | 句法 + 关系别名等侧信息 | 侧信息融合 | 针对远程监督噪声 |
| FastRE [IJCAI 2022] | 膨胀卷积编码器 | 关系类型映射 + 级联二元标注 | 训练速度提升 3–10 倍、推理速度提升 7–15 倍、参数约 1/100 |
| PasCore [IJCAI 2023] | — | 全局指针标注 | 中文重叠关系,对头结点用全局指针标注策略,综合关系和头结点类型标注尾结点 |
| fmLRE [AAAI 2023] | — | 迭代反馈 | 低资源场景,用基于特征映射相似度计算的迭代反馈提高伪标签正确率 |
FastRE 那条线的表述很直接:用膨胀卷积替代笨重 PLM,引入关系类型映射机制,「提升 3–10 倍训练速度、7–15 倍推理速度,模型参数缩小 100 倍」,性能相似或更好。
重叠关系
重叠关系(一对多)还有两处工作:Tan 2019(AAAI)的《Jointly Extracting Multiple Triplets with Multilayer Translation Constraints》做多三元组联合抽取;Online Noisy Continual Relation Learning(Li 等,AAAI 2023)面对在线流数据加噪声标签,做法是划分干净与噪声样例、自监督在线学习、半监督线下微调。
七、大模型这一段
零样本关系抽取与 SUMASK
零样本关系抽取有两条路线并列:Small Language Model 走 Meta Learning,Large Language Model 走 Prompting。直接 Prompting 的问题是「直接要求 LLM 通过指令从文本中抽取关系标签,缺乏中间步骤」。
SUMASK(EMNLP 2023)为估计不确定性,分别生成 k 个 [SUMMARIZE][QUESTION][ANSWER],计算表示之间的离散度来近似不确定性,把不确定性最低的关系作为最终预测;结论是优于其它零样本基线,甚至优于部分全监督基线。
表格化提示与指令上下文学习
Li 等(COLING 2024)用表格化提示(tabular prompting)做关系三元组抽取。LLM 的 ICL(in-context learning)关注两件事:prompt design(结构化提示更有利于 RTE,即 relational triple extraction)和 demonstration retrieval(高效选取与标注),原理是「测量两个未标注样本中包含的三元组集合的相似性,并根据整个测试数据选择最具代表性的样本进行标注」。
落到选型上的重新定义
对「知识抽取在大模型范式下」的重新定义,是给工程选型写的:知识密集型领域的构建需要领域专家深度参与;工业领域与传统场景差别很大(大量 ERP、CRM 系统,数据异构严重,缺乏训练模型的语料);大量长尾和离散知识,分布长尾、训练数据少、抽取困难且代价高;还有大量离散的、非记录的、机密的、高商业价值的知识需要持续总结。
落点不是「LLM 取代关系抽取」,而是「知识构建支撑工具集和平台」。对「利用知识」的提醒也适用:图天然稀疏、KGE 的低维向量不等于原始语义、知识不全与冲突普遍存在、大量应用停在浅层可视化与问答。
八、数据集与评测里的坑
覆盖到的数据集按出现顺序整理如下。
| 数据集 | 规模 / 构成 | 任务形态 |
|---|---|---|
| MUC / ACE | 只有关系类型清单 | 关系分类(小数量关系、标注实体、附加 WordNet 语义信息) |
| SemEval-2007 Task 4 | 7 个部分对应 7 种语义关系,各有训练 / 测试集 | 每个关系一个二分类任务;实体用 <e1>/<e2> 标注,参数手工 WordNet 消歧 |
| SemEval-2010 Task 8 | 超过 10000 条标注句子 | 单一多类别清单的多分类;需决策实体槽位,不提供 WordNet sense 与 query |
| Nastase & Szpakowicz [2003] | 600 个基础名词句子 | 5 类粗粒度 / 31 种关系两级层次的 N-N 复合词标注 |
| Kim & Baldwin [2005] | 华尔街日报 2169 个 noun-noun 复合词(1088 训练 / 1081 测试) | 20 种关系,允许多类别标注(训练 94 个、测试 81 个被标了多种关系) |
| Ó Séaghdha & Copestake [2007] | 英国国家语料库 1568 个名词复合词 | 8 种关系的复合词分类 |
| Tratz & Hovy [2010] | 大型语料库 + 华尔街日报 17509 个复合词 | 10 类 43 种关系,众包迭代开发 |
| FewRel(EMNLP 2018,清华 NLP 发布) | 100 个类别、70000 个实例,Wikipedia + Wikidata | 精标注;监督 / 远程监督可用,也面向少次学习 |
评测的坑有这么几处。
类别之间互不独立。 SemEval-2010 Task 8 那两组易混关系,Component-Whole 与 Member-Collection 都是 Part-Whole 的特例;Content-Container、Entity-Origin、Entity-Destination 要靠「所表达的状态是静态还是动态」区分。错误会集中在这几对上,报总体 F1 会把问题掩盖掉。
多标签。 Kim & Baldwin 允许多类别标注,意味着同一实例可以有多个正标签,按单标签 softmax 评测时,这些实例的分数和常规实例不能直接比。
负例从哪来。 SemEval-2007 式的二分类口径下,「负例怎么来的」决定了 P/R 的含义:负例是从其他关系部分采来的句子,采样比例一变,基线整体平移。跨论文比 F1 之前得先看评测协议,负例采样比例这一层通常没有展开写。
任务形态不同。 FewRel 那层的道理也在这:同一个数据集能报出完全不同的分数,取决于你在做 few-shot N-way K-shot 还是标准分类。涉及具体数值、原始材料没有明确给出的部分,这里不猜。
九、今天自建关系抽取为什么还是难,什么时候该用 LLM
先问关系体系从哪来
有本体、有知识库(ACE 那类封闭关系集),监督和远程监督都成立;如果关系是业务方「边聊边加」的,就只剩开放抽取加后置映射,而这条路「很难映射到知识库中」。这一步选错,模型再好也白搭。
再问有没有种子、有没有知识库可以对齐
连可信种子都给不出来时,别急着标数据,先跑 bootstrapping 看语义漂移有多严重(输赢、涨跌这类上下文依赖的关系,本来就不友好)。
有知识库可以对齐时,远程监督是唯一能把规模瞬间拉起来的办法,但必须提前设计去噪:实例级注意力(Zhou 2016 那层 Attention 的用法)、句法感知表示(He 2018 的 Tree-GRU)、侧信息(RESIDE)、实例选择(Feng 2018 的 RL)。它们要解决的是同一件事,让「这对实体有过 r 关系」这个知识库事实,不被语料里的偶然共现污染。
别忽略长尾与重叠
Downing 那句「新奇复合词使有限枚举徒劳」、BNC 里 60% 复合名词只出现一次、以及关于长尾的讨论,说的是同一件事:你标的关系类型覆盖高频,真实文本里却大量是三五个样本的尾部和一次性表述。重叠关系(一个实体对同时有多条边)也不是边缘情况,PasCore、Tan 2019、Takanobu 2019 都是冲它去的。
什么时候用 LLM
关系类型是自然语言描述的、标注极少甚至为零时,Prompting 加不确定性估计(SUMASK 那种 k 次生成再比离散度)是可用起点;有少量标注想往上抬,就往指令 / 上下文学习走。
反过来,要吞吐、要延迟、要私有部署时,FastRE 那条线(膨胀卷积替 PLM、参数约 1/100、推理快 7–15 倍)更贴近工程现实。该警惕的是把 LLM 当「免评测」的方案:你抽出的每条边都要被下游消费,错一条脏一片。
一种成本上说得通的组合
在多种方案之间,可以根据关系类型的确定程度分工:LLM 负责第一轮挖长尾和新关系、把种子池撑大,规则或小模型负责在确定关系集上高吞吐跑量,人只审置信度处于中间地带的那批。
这套流程没有成文版本,但从「知识构建支撑工具集和平台」这个落点看,方向是一致的:没有哪一层负责把所有事做完,选择哪种范式本质上是回答标注预算和噪声容忍度这两个问题。