第 03 篇讲了知识抽取的整体流程,这一篇拆开里面的第一道工序:命名实体识别(Named Entity Recognition, NER)。
它的定位很直白:NER 是标记出文本中预定义类型的实体的任务,通常建模为序列标注任务,是自然语言处理和知识图谱关键的上游任务,在医学、新闻和社交领域都有应用。定义里「预定义类型」这四个字,恰恰是后面所有麻烦的源头:类型定得越细、越新、越跨域,这件事就越不像序列标注。
一、任务本身:三大类、八小类,和一张标注表
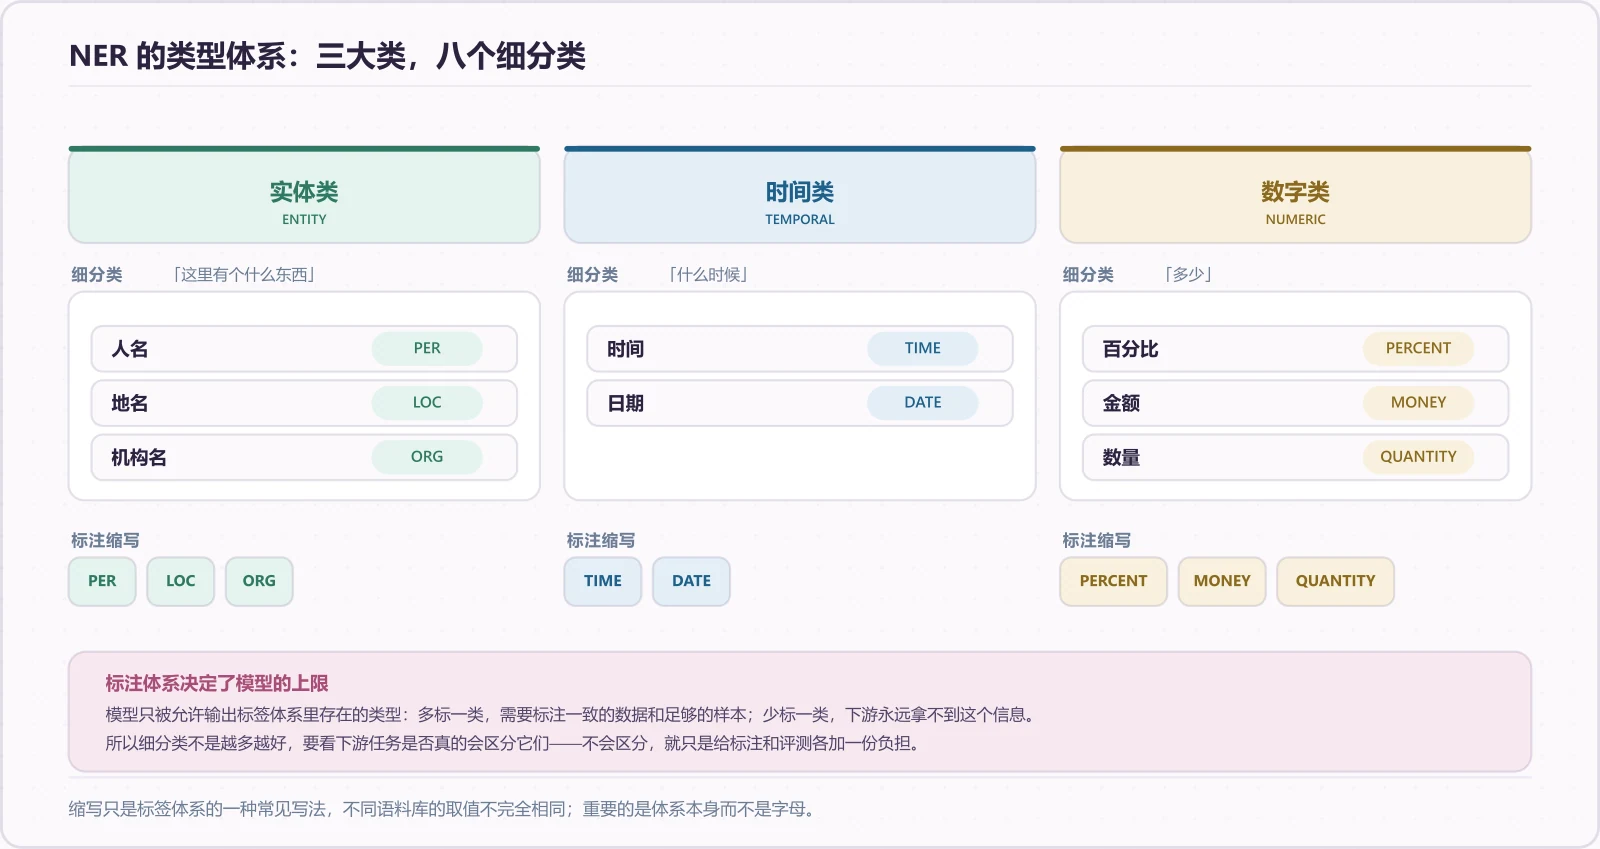
要识别的实体分成三大类,每类下面是具体的小类。
| 大类 | 小类 |
|---|---|
| 实体类 | 人名、组织 / 机构、地理位置 |
| 时间类 | 时间、日期 |
| 数字类 | 货币、百分比 |
清单后面跟着一个省略号,它是开放的,不是穷举的。后面 WNUT 2017 的六类、CrossNER 的领域专有类型,都是在这个开放清单上继续加项。
典型的示例句子是这样的:
北京时间3月23日0时50分许,美国总统特朗普在白宫正式签署对华贸易备忘录。
这句话里标出了「时间」(北京时间3月23日0时50分许)、「人名」(特朗普)、「地理位置」(白宫)、「货币」(600亿美元)。同一句话里同时出现四类实体,长度从两字到十几个字不等,这就是 NER 要面对的真实输入分布。
标注落到 token 上:四种体系
序列标注要落到 token 上。常见的体系有四种,IO、BIO、BIOES、BMEWO,用「特朗普在白宫」这段做对照:
| Token | IO | BIO | BIOES | BMEWO |
|---|---|---|---|---|
| 特 | I-PER | B-PER | B-PER | B-PER |
| 朗 | I-PER | I-PER | I-PER | M-PER |
| 普 | I-PER | I-PER | E-PER | E-PER |
| 在 | O | O | O | O |
| 白 | I-LOC | B-LOC | B-LOC | B-LOC |
| 宫 | I-LOC | I-LOC | E-LOC | E-LOC |
四种体系的取舍差别很大:
- IO 的致命问题是相邻同类实体没法分,「北京在华盛顿」会连成一片,工程里基本不用。
- BIO 是默认选项,它只用「开头」和「内部」两个标记,够用且最省标注成本。
- BIOES 多出 E 和 S,能显式表达实体结束与单字实体,代价是标签空间翻倍。
- BMEWO 里的 W 在上面的样例中没有体现,按 M = 中间、E = 结尾、W = 单字理解;这一套在中文上不如 BIOES 常见,属于存疑项。
这张表就能说明问题:标注体系的差别不在「标什么」,而在「边界信息给得够不够」。
二、评价:先看清楚 F1 是在什么条件下算的
标准做法是「与 ground truth 一致」,实体的边界和类型都对才算对。TP 是识别出且匹配 ground truth 的数量,FP 是识别出但不匹配的数量,FN 是没识别出的数量。P 测的是「找出的实体里对的比例」,R 测的是「该找的实体里找到了多少」,F 是两者的调和均值。
宏观平均与微观平均
这两个 F 值的算法不一样,含义也不一样。
| 口径 | 算法 | 等价于 |
|---|---|---|
| 宏观平均 F-score | 为每个实体类别独立地算 F,再对所有类别取均值 | 平等对待每个类别 |
| 微观平均 F-score | 聚合所有类别的实体分布再算 | 平等对待每个实体 |
这两个数字在类别不平衡时能差出十几个点。Few-NERD 有 66 个细粒度类型,长尾类样本极少,宏观 F 会被小类别拖下来、微观 F 被大类主导。论文报的是哪个、有没有说清,直接决定这个数字可不可比。这是读 NER 论文要第一个确认的事。
松弛匹配
还有一种「松弛匹配」:类型与 ground truth 一致,但边界只要被 ground truth 覆盖即可,实际应用范围不大。它的价值在诊断:严格匹配 F1 低、松弛匹配 F1 高,问题基本出在边界而不是类型判断上。
三、方法演进:一条被讲得很完整的线
方法脉络按阶段顺下来比较清楚,下面按顺序走一遍,并贴上各阶段的关键名字。
规则与词典
流程三步:预处理(划分句子、分词加词性标注、构建词典)→ 识别实体边界(词典匹配、拼写规则、特殊字符、特征词和标点符号等)→ 命名实体分类(分类规则、基于词典的分类)。词典在三处发挥作用:辅助分词、实体抽取时匹配、基于词典分类。
词典本身也可以半自动地建出来,常见套路有几路:
| 手段 | 做法 |
|---|---|
| 词频统计 | 去停用词后统计词频、选取一定范围的名词 |
| 关键词抽取 | TF-IDF、TextRank |
| 百科分类体系 | 借助维基百科页面的分类系统 |
| 特征词分词 | 词共现、特定模式 |
| 词性分析 | 从标记为人名 nh、组织 ni、日期 nt 等词中抽取 |
| 依存句法分析 | 用句法结构筛候选 |
这些统计方法产出候选词典后,用人工筛选,同时人工提取领域重要术语并复用现有词典。综合中文语义词库常被点到的有 CSC、hownet 和 Chinese Open Wordnet。
这套流程今天没死,只是换了地方活,它现在是「弱标注 + 人工审核」的冷启动方案。把「人工筛选」写进流程,等于承认纯统计建词典不可靠。
统计模型
这一段的代表工作有四类:隐马尔科夫模型(Hidden Markov Model, HMM)、最大熵马尔科夫模型(Maximum Entropy Markov Model, MEMM)、条件随机场(Conditional Random Fields, CRF)、支持向量机(Support Vector Machine, SVM)。
前两个的定位写得很省字但很准:
- HMM:有向图模型、生成模型、特征分布独立假设
- CRF:无向图模型、判别式模型、无特征分布独立假设
这正是 CRF 长期霸占序列标注解码层的原因。HMM 的观测独立假设吃不进「前一个词是大写」「这个词在词典里」这类重叠特征,而 NER 恰恰靠这些特征。
深度学习
按论文顺序看是三个阶段,把「分布式输入表征 + 上下文编码器 + 标注解码器」这个三段式定了下来。
| 工作 | 做法 | 出处 |
|---|---|---|
| NN/CNN + CRF(Collobert et al.) | 分 window approach(词级对数似然,softmax)与 sentence approach(句子级对数似然,CRF)两种粒度 | 2011 |
| Bi-LSTM + CRF(Lample et al.) | 同样分 word-level 和 character-level | 2016 |
| Bi-LSTM-CNN-CRF(Ma and Hovy) | 用 CNN 拿字符级表示 | 2016 |
前沿进展把这套结构总结成 NER 系统的三个组件,其中第一条特别值得画线:把词映射成低维稠密向量,这些语义和句法属性是自动学到的,并没有显式出现在 NER 输入中。
半监督与迁移学习
半监督的代表是 Peters et al. [2017] 的 TagLM:用海量无标注语料训练 Bi-LSTM 语言模型 → 取 LM embedding 和 word embedding → 两者混合后喂给序列标注模型。这是 ELMo 那条线的起点。
迁移学习先要看清它和传统机器学习的差别:数据分布相同对数据分布不同、需要足够标注对不需要、分别建模对可跨任务迁移。迁移学习有三种模式:跨域、跨应用、跨语言,对应 Yang et al. [2017]。
预训练
Devlin et al. [2018] 的 BERT 结构就是 Transformer Encoder。它的两个预训练目标值得细看:
- Masked LM:随机选 15% 的词,其中 80% 真打
[MASK]、10% 随机替换、10% 不动,模型预测这些位置,且可以从前后两个方向预测。 - NSP:二分类,50% 概率输入「句子 + 下一句」(正例),50% 输入「句子 + 随机句」(负例)。
把这六个阶段并排放在一起,各自的表示方式与解码方式差别很明显。
| 阶段 | 代表方法 | 表示方式 | 解码 | 主要解决什么 |
|---|---|---|---|---|
| 规则与词典 | 词典匹配 + 分类规则 | 人工特征 / 词表 | 规则 | 领域内高频实体,可控可解释 |
| 统计模型 | HMM / MEMM / CRF / SVM | 人工特征 | HMM 生成式;CRF 判别式 | 免去手写规则,标签间转移可建模 |
| 深度学习 | Collobert [2011]、Lample [2016]、Ma & Hovy [2016] | 词向量 + 字符级 CNN | CRF | 自动学特征,字符级表示缓解未登录词 |
| 半监督 | TagLM [2017] | 词向量 + LM 向量 | 序列标注层 | 用海量无标注语料提升泛化 |
| 迁移学习 | Yang et al. [2017] | 跨域 / 跨应用 / 跨语言共享 | — | 目标域标注稀缺 |
| 预训练 | BERT [2018] | 双向上下文表示 | 微调 + 标注层 | 一次预训练,多任务复用 |
四、前沿:难点被拆成了若干个方向
前沿进展列了五个常见任务(CoNLL 2003、CoNLL++、WNUT 2017、Ontonotes v5、Few-NERD)和五个衍生方向(Few/Zero-Shot NER、Continual NER、Nested NER、Cross Domain/Domain specific NER、Multi-modal NER)。下面按「在解决哪个难点」拆。
边界与标签噪声
CoNLL 2003 是新闻专线文本(Reuters RCV1 语料库),四种类型 PER / LOC / ORG / MISC,用基于跨度的 F1 评估。榜首 ACE + document-context(Wang et al., 2021,F1 94.6)做的是自动化嵌入连接(Automated Concatenation of Embeddings, ACE),用强化学习驱动的控制器搜索嵌入拼接方式。
第二是 LUKE(Yamada et al., 2020,F1 94.3),把词和实体都当独立标记来预训练。
更有意思的是 CoNLL++。Wang et al. [2019] 的 CrossWeigh 发现 CoNLL 2003 里约 5.38% 的测试句子存在标签错误,而当时测试 F1 已在 93% 左右;人工纠正后得到 CoNLL++,修正测试集约 5% 的实例,训练集不变。CrossWeigh 本身是个训练框架:把训练数据切成多份、分别训练独立模型找出各部分的潜在错误,再据此调整数据权重。
这组数字指向一个很实际的结论:当模型 F1 已逼近标注质量上限时,修数据的收益可能大于继续刷榜。
上下文缺失
CL-KL(Wang et al., 2021)针对的是「文档级上下文能提升 NER,但很多场景拿不到」这个矛盾:把原句当查询丢进搜索引擎检索相关文本,用重排序模型筛出 top l 作外部上下文,再用合作学习(Cooperative Learning)约束两个视图产生一致的表示和输出分布,跨 5 个领域的 8 个数据集达到 SOTA。
标签语义的表示
Flair embeddings(Akbik et al., 2018)的做法是:句子作为字符序列进预训练双向字符语言模型,每个词的嵌入由正向 LM 在末字符之后的隐状态、反向 LM 在首字符之前的隐状态拼接而成,即上下文字符串嵌入(Contextual String Embedding)。论文把可用嵌入归为三类:经典词嵌入、字符级特征、上下文化词嵌入。
少样本与零样本
这三篇的思路层层递进。
Leveraging Type Descriptions for Zero-shot NERC(ACL 2021) 是第一种零样本 NERC 方法,靠实体类别的文本描述把已见类信息迁移到未见类。模型叫 SMXM,用交叉注意力编码器建模句子与类型描述的关系,在 OntoNotes 和 MedMentions 上评估。它点出一个零样本特有的坑:负类(not-an-entity)定义不清,训练时标为非实体的词,测试时可能属于目标类。例子是 Huaqiao Park 与 Shantou Harbour 都是 Facility,前者在训练期却标成非实体。为此它试了基于描述编码、独立编码、Class-aware 编码三种做法。
Learning from Miscellaneous Other-Class Words for Few-shot NER(ACL 2021) 提出 MUCO,从 O 类词里挖掘未定义类别。例子是:若 Newton 能被 he 或 professor 替换,这两个词就构成一个未定义但有用的类别,反过来提供「Newton 会出现在哪」的先验。做法是原型学习 → 训二分类器判断两点有无聚类倾向 → 推断 O 类中的例子对。1-shot 和 5-shot 上优于 5 个 SOTA。
SpanNER: Learning from Language Description(EMNLP 2021) 把 NER 拆成跨度检测 + 实体类别推理联合训练,既避开「类别当独热向量、学不到标签语义」,也避开「纯原型方法依赖标注样本、扩不到零样本」。类别推理以跨度表示为 Q、类别描述 token 表示为 K/V 做多头注意力。三种设置下比最佳基线平均提升 10%、23%、26%。
持续学习
Continual Learning for NER(AAAI 2021) 面对的是:新实体类型不断出现,但重标原始数据受存储和安全限制、代价高,甚至不可能。它只用新类型标注的新数据,靠知识蒸馏巩固旧知识(教师 M_t 蒸馏给学生 M_t+1)。
两种学生结构的做法如下。
| 结构 | 做法 |
|---|---|
| AddNER | 克隆后加一层识别新类型 |
| ExtendNER | 把输出层从 h×(2n+1) 扩到 h×(2n+2m+1),维特比解码 |
实验把 CoNLL2003 和 OntoNotes 切成 4 个和 6 个子集,每子集只用一种类型标注,并考虑多种切分顺序取平均。那个维度变化把持续学习的代价说得很具体:每加一类,输出层就长一截,旧参数还不能乱动,只能靠 KD 损失摁住。
嵌套实体
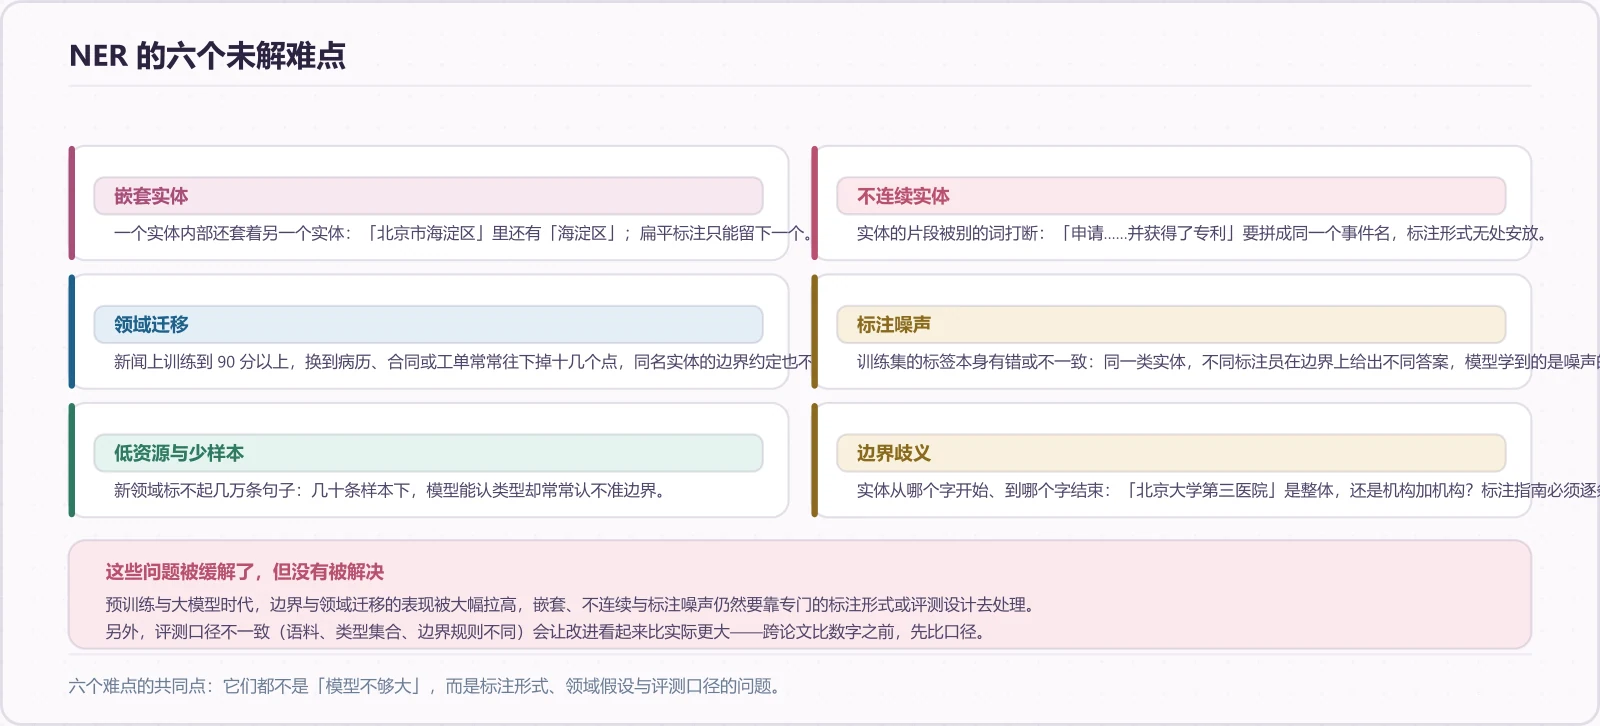
这一节的判断下得很硬:简单的序列标记技术无法对这些结构建模,因此带有嵌套结构的 NER 仍然很困难。而嵌套由于实体的组成性,在许多领域都能观察到,例如「北京大学」里嵌着「北京」,「Former Hogwarts headmaster Albus Dumbledore」里嵌着机构与职称。
围绕它有一批工作,各自换了一个着力点。
| 工作 | 出处 | 做法与结果 |
|---|---|---|
| Nested NER with Partially-Observed TreeCRFs | AAAI 2021 | 把嵌套 NER 看成用部分观测树做成分分析,标注的实体跨度是观测节点,其他跨度是潜在节点,用 TreeCRF 统一建模;为算部分树的概率提出 MASKED INSIDE 算法,对不同节点做不同推理操作。ACE2004、ACE2005 上 SOTA |
| Locate and Label: A Two-stage Identifier for Nested NER | ACL 2022 | 针对基于跨度的方法的四个毛病:计算成本高、忽略边界信息、用不上部分匹配的跨度信息、长实体难识别。两阶段:先过滤种子跨度并做边界回归定位实体,再对调整后的跨度分类。KBP17 / ACE04 / ACE05 的 F1 分别提升 +3.08% / +0.71% / +1.27% |
| Nested NER via Explicitly Excluding the Influence of the Best Path | ACL 2021 | 分层方法,每个时间步维护一组隐藏状态(chunk),让每个标签自己选最相似的 chunk 取发射分数,而非「第 L 层用第 L 个 chunk」。它还证明内部实体优先识别优于外部实体优先,举例「Former Hogwarts headmaster Albus Dumbledore」,从外开始时第一层全判 PER,到第四层才分出 Hogwarts 和 headmaster |
| HiTRANS: A Hierarchical Transformer Network for Nested NER | ACL 2021 | 把句子分解成多粒度跨度,用自底向上 + 自顶向下的 Transformer 聚合上下文生成跨度表示,再做分层标签预测 |
| EWT-NNER | ACL 2021 | 补数据和评测的口子。在 English Web Treebank 上标注嵌套实体,覆盖 5 个 web 领域、4+2 个类型(LOC/ORG/PER/MISC 加 -part、-deriv 子类型),共跨 12 个类,并给了德语、丹麦语的迁移结果 |
EWT-NNER 的规范很细,需要记下几条:只有完整名词性短语算潜在实体、代词忽略、限定词和标题不算;实体可以是 token 的一部分([Thailand-based]LOCpart)或派生的(the [Alaskan]LOCderiv movie);地缘政治实体第一解读标 ORG、第二解读标 LOC。
嵌套 NER 的瓶颈一半在模型,一半在「什么算实体」本身没有共识。这也是后面工程清单里「标注手册要先写清边界」那条的由来。
跨域与领域专有类型
CrossNER(AAAI 2021) 指出已有数据集的通病:目标集与源集要么太像、要么差太远,实体类别差距过大,跨域评估效率低。它的数据覆盖 5 个领域(politics、natural science、music、literature、artificial intelligence),做法是收无标签 wiki 数据 → 用 DBpedia Ontology 预标记 → 用两个训练好的 NER 标记器加一位专家标注。
结论是:专注含领域专有实体的那部分语料、并在领域自适应预训练中用更有挑战性的策略,对领域适应有利。
另外两篇走的是别的路:
- Explicitly Capturing Relations between Entity Mentions via GNN for Domain-specific NER(ACL 2021):用图神经网络显式连接两类关系,全局共引用关系(指向同一实体的提及,靠准确匹配、词元匹配、首字母匹配)和局部依赖关系(句级依赖找语义相关提及)。AnatEM 上 84.41% 对 BioBERT 83.53%,Mars 上 90.57% 对 SciBERT 89.95%;这套轻量系统在标注数据很少时也有效。
- TEBNER: Domain Specific NER with Type Expanded Boundary-aware Network(ACL 2021):远程监督路线,按词典自动打标。两个问题被明确列出:标注不完整(词典覆盖不全面,大约只有 50%)和对新的实体毫无办法。它用 Dictionary Extender 从未标注数据抽高质量短语(AutoPhrase)作候选、用 entity typing model 分类后扩进词典;识别端叠了三种标注方案:Break or Tie(词级,判断相邻两 token 是否属同一 mention)、BIO(句级)、Phrase Matching(全文级)。数据集是 BC5CDR、NCBI-Disease、LaptopReview。
多模态
这一路的假设很朴素:视觉上下文有助于解决有歧义的多义词。UMGF: Multi-modal Graph Fusion for NER with Targeted Visual Guidance(AAAI 2021) 用统一多模态图表示句子和图像,节点是词和视觉对象,边分模态内(同模态任意两点相连)和模态间(通用词提取的视觉对象连所有文本顶点,名词性短语提取的视觉顶点只连对应短语的文本顶点)。视觉对象来自目标检测,文本侧用 Stanford parser 抽名词性短语。
在 Twitter-2015、Twitter-2017 上的结论是:BERT-CRF 优于 HBiLSTM-CRF、BERT-CRF 优于纯 BERT(说明 CRF 有效)、多模态总体优于纯文本、UMGF 优于 UMT。
社交媒体的新实体
WNUT 2017 关注「在高差异环境中记忆以外的泛化」,标 6 类(个人、地点、群体、创造性工作、产品、公司),并在实体块实例和唯一实体表面形式上分别给分,以标准化频繁出现实体的偏差影响。
| 榜单 | 成绩 |
|---|---|
| WNUT 2017 榜首 InferNER(Moemmur et al., 2021) | F1 50.52 |
| WNUT 2017 第二名 CrossWeigh + Flair | 50.03 |
| CoNLL++ 榜首 | 94.81 |
同一组对比的信息量最大:同一个任务名,一个是新闻书面语、一个是带噪推特;一个接近天花板,一个还在及格线挣扎。数据分布决定的可达上限,比模型选择的影响大得多。
五、还没解决的问题:一份按解决程度排的对照
把两份不同年份的前沿进展并排读,会得到一条有点尴尬的结论:旧版和新版的内容几乎逐字相同,连表格里的 F1 和论文列表都没变。 换句话说,这里呈现的「前沿」,稳定期至少有两年。
所以下面这张表按「这个问题被解决到什么程度」来分,而不是按年份。
| 难点 | 代表工作 | 解决到什么程度 |
|---|---|---|
| 边界错误 | CrossWeigh / CoNLL++(发现 5.38% 测试句标错);Locate and Label 的边界回归 | 数据侧和模型侧都在动,但边界仍是主要错误来源 |
| 嵌套实体 | TreeCRF(部分观测树)、Locate and Label、Excluding Best Path、HiTRANS | 模型方案很多、单数据集能刷上去,评测口径仍不统一(EWT-NNER 就是来补这个的) |
| 标签噪声 | CrossWeigh(切分 + 重加权) | 有可用框架,代价是要多训几遍模型 |
| 上下文缺失 | CL-KL(检索外部上下文 + 合作学习) | 单句场景下有解,依赖检索质量 |
| 少样本 / 零样本 | SMXM(类型描述)、MUCO(挖 O 类)、SpanNER(描述 + 跨度分解) | 有系统性提升,但零样本下负类定义仍是结构性问题 |
| 领域迁移 | CrossNER、GNN 连提及、TEBNER | 领域自适应预训练有效,跨域仍是「说明任务有挑战」级别的结论 |
| 新类型持续出现 | Continual NER(KD + AddNER / ExtendNER) | 能防遗忘,但每加一类都要动输出层 |
| 新词与噪声文本 | WNUT 2017 榜面(最高 50.52) | 远未解决 |
| 多模态消歧 | UMGF | 有增益,前提是图像真的相关 |
| 细粒度类型 | Few-NERD(8 粗 / 66 细)、SpanNER 的类别注意力、MUCO | 数据集建起来了,基准 BERT-Tagger 只有 68.88 |
| 不连续实体 | 本系列未涉及 | 待补充 |
关于 Few-NERD
大规模、细粒度、手工标注的英文数据集,8 种粗粒度类型、66 种细粒度类型、188,200 个句子、491,711 个实体、4,601,223 个标记,并构建了三个基准任务:SUP(标准 NER)、INTRA(跨不同粗粒度类型的少样本)、INTER(粗粒度类型内的少样本)。榜上的 BERT-Tagger(Ding et al., 2021)F1 是 68.88。
这份清单的边界
上表列出的这些方向里没有「不连续实体」,两个年份版本也都没有出现生成式大模型做 NER 的内容,方法线停在了「预训练编码器 + 跨度分类 / 序列标注」。所以「到大模型」这一半,材料的覆盖范围到此为止:本篇不对 LLM 生成式抽取做事实性陈述。
六、工程视角:一份上手清单
中文建议以字为单位标注
标注示例用的就是按字切的 token(特 / 朗 / 普),前面提到的方法里 Bi-LSTM+CRF 明确分 word-level 和 character-level,HiTRANS 也用字符级表示。以字标注能绕开分词错误传导:分词一旦切错,基于词的表示会把错误固化到标签里。
评测口径先确认三件事
基于 token 还是基于跨度(CoNLL 2003 用的是基于跨度的 F1);宏观还是微观平均;测试集干不干净,CrossWeigh 那 5.38% 摆在那儿,建议先抽样复核自己的测试集标注。
标注手册要先写清边界
参照 EWT-NNER:限定词和标题算不算、代词算不算、时间类实体粒度到哪一级、地缘政治实体的类型优先级。这些不定,不一致会慢慢烂在数据里:它不会立刻表现为指标下降,而是表现为标注者之间长期的隐性分歧。
嵌套是设计问题,不是调参问题
「简单的序列标记技术无法对这些结构建模」是硬约束。数据里有嵌套(医学、法律、新闻标题常见),序列标注的标签体系从第一天就不够用。要么换跨度分类(Locate and Label 的两阶段),要么用分层方案且从内部实体开始。
冷启动有三条熟路
词典辅助(分词 / 匹配 / 分类)、远程监督扩词典(TEBNER 提醒:词典覆盖可能只有 50%,且对全新实体无效)、CrossNER 式的领域语料 + 领域自适应预训练。
少样本别只盯原型网络
对原型方法的两条批评很实在:同类下的 token 不一定彼此接近,原型会有噪声;且原型依赖标注样本,扩不到零样本。SpanNER 和 MUCO 就是绕开它的两条路。
七、一段最小示例
上面那些标注体系落到代码上就是一个列表。BIO 走一遍「特朗普在白宫」:
tokens = ["特", "朗", "普", "在", "白", "宫"]
tags   = ["B-PER", "I-PER", "I-PER", "O", "B-LOC", "I-LOC"]

# B- 开新实体,I- 续接同一实体,O 不属于任何实体
# 合并规则:遇 B-X 开始新跨度,遇同类 I-X 则延长,遇 O 或其他类型则收尾
spans, cur = [], None
for tok, tag in zip(tokens, tags):
    if tag.startswith("B-"):
        if cur: spans.append(cur)
        cur = [tag[2:], tok]
    elif tag.startswith("I-") and cur and cur[0] == tag[2:]:
        cur[1] += tok
    else:
        if cur: spans.append(cur); cur = None
if cur: spans.append(cur)
print(spans)   # [['PER', '特朗普'], ['LOC', '白宫']]
换成现成的预训练模型,同一件事可以只写几行。下面是一段公开常识范围内的最小调用写法,与上面的方法线无关,具体工具版本需要按实际情况核对。
# 用现成的预训练模型做一次推理(示意)
from transformers import pipeline
ner = pipeline("ner", model="bert-base-chinese",
               aggregation_strategy="simple")
for e in ner("特朗普在白宫签署了备忘录"):
    print(e["entity_group"], e["word"], round(e["score"], 3))
aggregation_strategy 做的就是上面那段手写逻辑:把 BIO 合并回跨度。起决定作用的是模型选择、标签体系与业务类型的对齐程度,以及测试集里有没有噪声。
八、结论
NER 的教科书部分早就稳定了:三大类、BIO 系标注、P/R/F1、BiLSTM-CRF 到 BERT 的主干。
难题全部集中在「预定义类型」这个前提上。 类型定得越细(Few-NERD 的 66 类)、越新(WNUT 的 50 分)、越跨域(CrossNER)、越没标注(少样本 / 零样本)、越有结构(嵌套),任务就越不像「序列标注」,越像「在没有数据的开放类别集合上做判定」。
答案方向也蛮一致:别再让类别只当一个 one-hot 符号。 SMXM 和 SpanNER 拿类别的自然语言描述当输入,MUCO 从 O 类里现场发现新类别,CrossNER 用领域语料做自适应预训练把类型空间往目标域挪。三条路都在给「类型」本身一个可迁移的表示。