第 01、02 篇讲的是知识层:怎么表示知识、怎么定 schema。这一篇往上游走一层,看知识是怎么从原始文本里被取出来的。
抽取在整条链路上处在最前面,也决定了后面所有环节的上限。上一层的本体建模有个容易被讲成哲学问题的动机:柏拉图在《理想国》里的洞穴寓言意味着存在一个不依赖人类认识的外在知识体系,人类摸索知识的过程只是不断接近它,永远达不到。这个说法决定了很实际的一件事,抽取出来的东西天然不完美,后面所有关于质量、评估、融合的讨论,都是在给这个「永远达不到」收尾。
一、先看数据从哪来
在谈方法之前,要先看抽取的输入是什么。常见的数据源可以切成三块,三块对应三条技术路线,后面的展开也基本按这个顺序走。
| 数据类型 | 典型来源 | 抽取的起点 |
|---|---|---|
| 结构化 | 数据库、规范的表格、社交网络 | 表结构与字段直接映射为类和属性 |
| 半结构化 | 百科 InfoBox、带模板的页面 | 固定的字段名与位置可以当模板用 |
| 非结构化 | 网页、新闻、社交媒体、论文 | 只能靠语言技术从句子本身分析 |
这三类之外还有图片、视频这类多媒体数据,第 06 篇讲事件抽取时会再碰到多模态这一路。
信息抽取与知识抽取不是一回事
有两个词经常混用,维基百科给的定义把它们分得很清楚。
- 信息抽取(Information Extraction, IE):把非结构化、半结构化文档里的结构化信息自动抽出来。
- 知识抽取(Knowledge Extraction, KE):从结构化(关系数据库、XML)和非结构化(文本、文档、图像)源里创造知识,产出必须是机器可读、机器可解释的格式,并且要方便推理。
最简的一句话区别是:信息抽取得到结构化数据,知识抽取得到机器可理解和处理的知识,也就是知识表示。两者的关系是,知识抽取建立在信息抽取之上,两者都普遍用到自然语言处理技术、基于规则的包装器和机器学习方法。
这个差别落在工程上很具体。抽出一张三列表格,和抽出一段能被推理引擎消化的东西,中间差的是「关系对齐到哪个谓语、实体挂到哪个类」这类建模决策。IE 那一层不关心这些决策,KE 这一层必须回答。
二、三大子任务和它们的边界
直接落到无结构化文本这块,局面是清楚的:这是当前知识图谱构建的技术瓶颈,关键技术有三个:实体识别、关系抽取、事件抽取。
实体识别
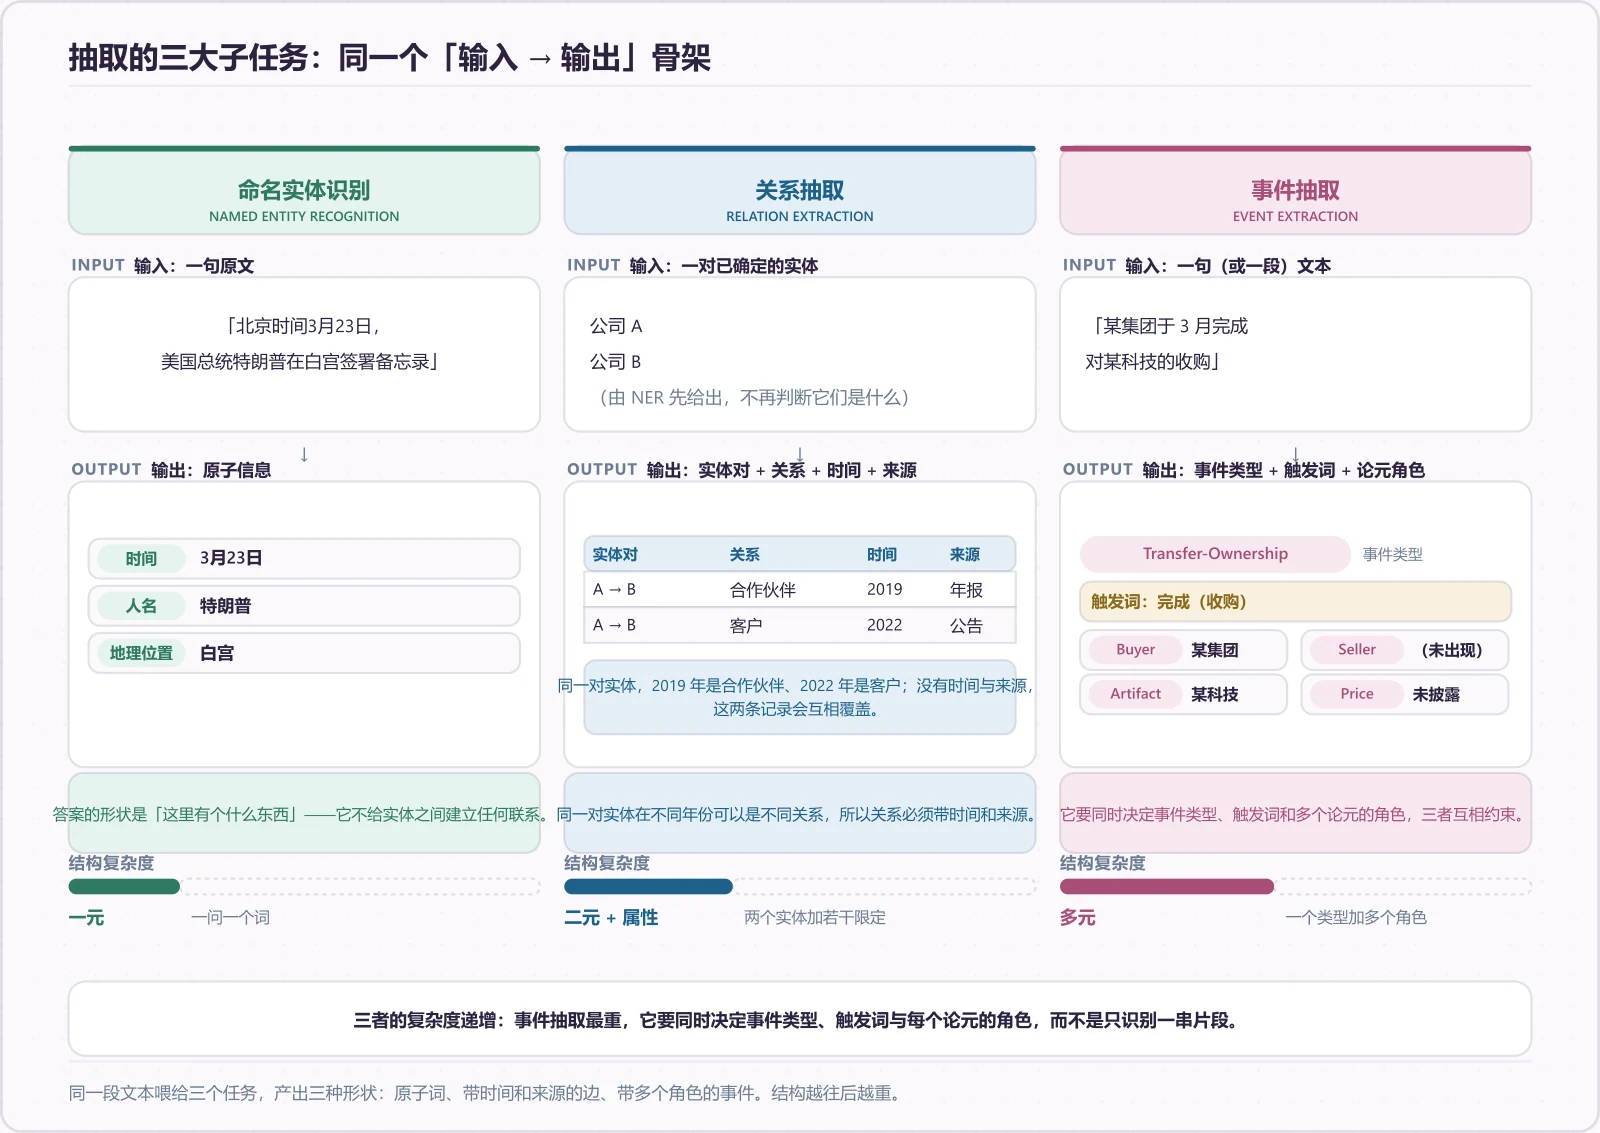
实体识别(Named Entity Recognition,NER) 要抽的是文本里的原子信息:人名、组织或机构、地理位置、时间或日期、金额等。一条新闻就能说明问题:
北京时间3月23日0时50分许,美国总统特朗普在白宫正式签署对华贸易备忘录。
这句话里,「北京时间3月23日0时50分许」落在时间上,「特朗普」落在人名上,「白宫」落在地理位置上。这三个片段形状完全不同,一个是长短语、一个是三字人名、一个是双字地名,识别器要处理的是这种长度和构成的差异。第 04 篇专门讲这一步。
关系抽取
关系抽取抽的是实体间的语义关系。有两张表放在一起看,这个细节值得留意:一张是「中兴通讯:卓翼科技(002369)—客户—2013.03.05—中国证券网:公司公告」,另一张里同一对实体在不同年份分别被标成「合作伙伴」和「客户」。
也就是说,抽出的关系要带时间和来源,同一对实体可以有多条随时间变化的关系。这点做 schema 设计时很容易漏,第 05 篇展开。
事件抽取
事件抽取的定义可以写得很完整:事件是具有时间、地点、参与者等基本元素,可由某个动作触发或者状态改变而发生的一个图结构知识片段;事件抽取就是从数据中抽取事件信息并以结构化和语义化形式展现,例如事件发生的时间、地点、原因、参与者。
典型的事件 schema 例子是 Attack 与 Transfer-Ownership 两个事件类型,带 Trigger 和 Argument Role,后者包括 Attacker、Target、Instrument、Time、Place、Buyer、Seller、Beneficiary、Artifact、Price 等,对应的句子是:
The man accused of killing seven people near Boston on Tuesday got his guns in Massachusetts.
三者的边界怎么切
三个子任务回答的是三个不同的问题,边界可以按「问什么」来切。
| 子任务 | 回答的问题 | 输出结构 |
|---|---|---|
| 实体识别 | 这里有个什么东西 | 文本片段加类型 |
| 关系抽取 | 两个已确定的东西之间是什么关系 | 实体对加关系类型 |
| 事件抽取 | 发生了什么事、谁参与、什么时候在哪 | 事件类型加触发词加多个论元角色 |
事件抽取在结构上比前两者重,因为它要同时决定事件类型、触发词和多个论元角色,一次判断的出错组合比前两者多得多。第 06 篇专门展开。
三、输入输出到底长什么样
教科书式的形式化定义段落不多,但三处材料拼起来就是一套完整的规格。
标注体系
三个子任务各自落到不同的标注形式上。NER 那部分按标注体系落到 token 上,关系抽取是「实体对 + 关系 + 时间 + 来源」的表结构,事件抽取给出了事件类型 + 触发词 + 论元角色的槽位结构。
映射规则:从关系数据库到知识库
结构化那一路的原理可以写成一张对照表,按这五条就能把关系数据库转成知识库。
| 关系数据库 | 知识库 |
|---|---|
| 表(Table) | 类(Class) |
| 列(Column) | 属性(Property) |
| 行(Row) | 资源 / 实例 |
| 单元(Cell) | 属性值 |
| 外键 | 指代 |
这一路的两个标准是 Direct Mapping 和 R2RML(RDB to RDF Mapping Language),工具层这一层常被点到的是 D2R、Virtuoso、Oracle SW、Morph 等。R2RML 的输入是数据库表、视图、SQL 查询,输出是三元组。
# R2RML 风格:把一列映射到一个谓词(示意写法)
<#EmpMap> rr:logicalTable [ rr:tableName "员工" ] ;
          rr:subjectMap   [ rr:template "http://ex.org/emp/{工号}" ; rr:class ex:Employee ] ;
          rr:predicateObjectMap [ rr:predicate ex:dept ; rr:objectMap [ rr:column "部门号" ] ] .
序列标注的输出习惯
NER 一般按字符或词打标签,BIO 是最常见的一套:B-X 表示 X 类实体的开头,I-X 表示内部,O 表示不属于任何实体。「特朗普」这三个字就落成 B-PER + I-PER + I-PER。这套命名的细节在任何一本序列标注的书里都能查到,但它和「抽取文本中的原子信息」这种颗粒度是同一件事,第 04 篇会把四种标注体系放在一起对照。
最后落到「知识」这一层
「110」这个例子把数据、信息、知识分得很开:对计算机来说 110 只是数据,只有建出下面这种结构,系统才完全知道它的意义。
(110, is-a, 公安报警电话号码)
四、范式是怎么变的
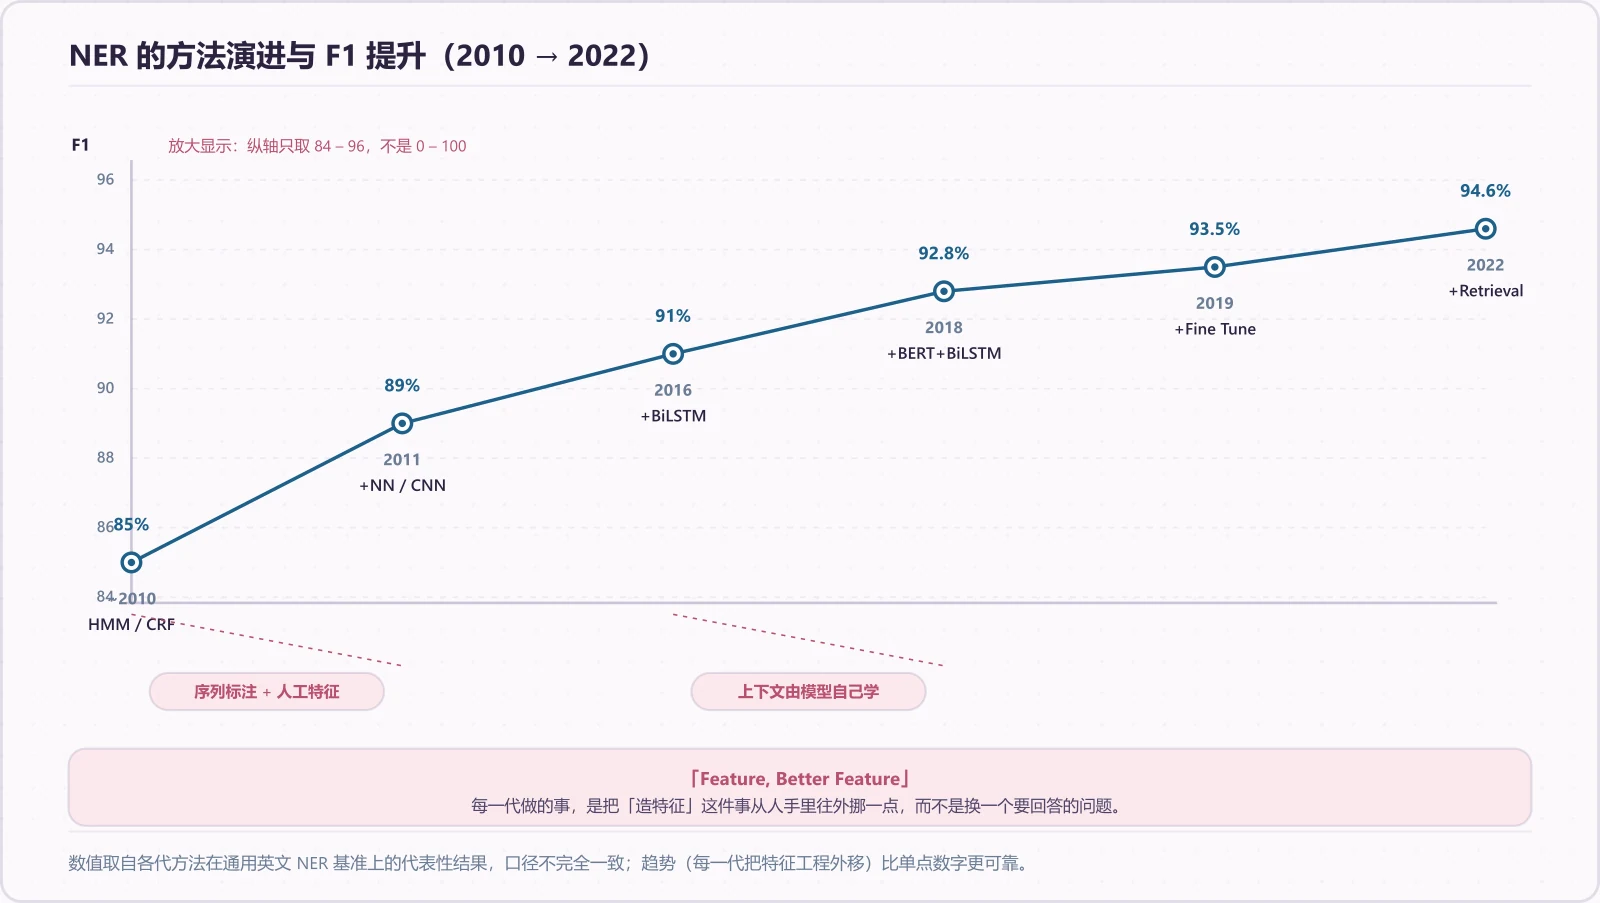
最能说明范式变化的,是一张 NER 从 2010 到 2022 的方法与成绩时间轴。
| 时间 | 方法 | F1 |
|---|---|---|
| ~2010 | HMM/CRF | 85% |
| 2011 | +NN/CNN | 89% |
| 2016 | +BiLSTM | 91% |
| 2018 | +BERT+BiLSTM | 92.8% |
| 2019 | +Fine Tune | 93.5% |
| 2022 | +Retrieval | 94.6% |
这条曲线背后的标注是「Feature, Better Feature」,更好的特征。这句话基本就是四十年范式的注解:每一代做的事都是把「造特征」这件事从人手里往外挪一点,而不是换问题。
规则与符号的时代
这一代把抽取能力写死在规则里。百科一路最典型:DBpedia 从维基百科按固定模式抽 abstract、infobox、category、page link,并给出对应谓词。
| 维基百科的构成 | DBpedia 里的谓词 |
|---|---|
| 标题 | label(rdfs:label) |
| 短摘要 | rdfs:comment |
| 长摘要 | dbpedia:abstract |
| 维基共享图片 | foaf:depiction |
| infobox 模板名 | rdf:type |
| 条目分类 | dc:terms/subject |
| 重定向页 | owl:sameAs |
| 消歧页 | dbpedia:disambiguates |
YAGO 则是「Wikipedia + WordNet」整合,规模是 1000 万实体、1.2 亿三元组,YAGO2 又接入 GeoNames 补时空信息。它的抽取与推断靠规则完成,规则本身分四种:
| 规则类型 | 做法 |
|---|---|
| 同义属性映射 | 人工定义,把不同来源的写法归到同一个属性 |
| 定义域与值域 | 给每个属性定 domain 和 range,以此做推断与清洗 |
| 类型启发式 | 优先首字母是名词且可数的,GDP → HasGDP、Children → HasChild |
| 分类启发式 | 实例有「Rivers in Germany」分类,就推它 LocatedIn Germany |
中文那一路可以看 Zhishi.me,中文大规模开放链接数据,1.0 版本约 1000 万实体、2 亿三元组。
这一代的账很清楚:规则可解释、可审、不要标注;代价是写得慢、迁移差,换个领域就得重写,规则之间的冲突也没有人替你兜。
监督与统计的时代
HMM/CRF 是这一代的主力,靠的是词性、词典、上下文窗口这些人工特征。它把「写规则」变成了「标数据 + 挑特征」,本质上是拿标注换泛化。好处是终于有了统一的训练框架和可比较的 F1,坏处是特征工程成了最吃人力的环节,而且跨领域掉点依旧严重。
神经网络那一段
这一段有三个代表工作,指向三种补短板的方式,共同点是人工特征被表示学习接管。
| 工作 | 做法 | 出处 |
|---|---|---|
| Flair Embedding(Akbik 等) | 构造更好的嵌入:正向取开头到当前的上下文特征,反向取结尾到当前的上下文特征 | COLING 2018 |
| 神经结构搜索(Wang 等) | 用 ACE 自动搜索嵌入的拼接方式 | ACL 2021 |
| LUKE(Yamada 等) | 在预训练架构里显式考虑实体,引入实体类型嵌入和语境化表示 | EMNLP 2020 |
代价是依赖标注语料的规模,以及模型越来越不好解释。
远程监督
远程监督(distant supervision)是把外部知识库当「免费标注员」。Mintz 等的规模很直观:Freebase 的 102 种关系、17000 个种子实例,映射到当时 120 万篇维基百科文章,最终抽出 180 万个实例、连接 94 万个实体。流程分两个阶段,训练阶段用 NER 标 person / organization / location,对 Freebase 中出现的实体对提特征、训一个多类别逻辑回归;测试阶段把句子里出现的每对实体都当潜在关系实例送进模型。
它的代价也来自这个流程:知识库说 (e1, r, e2) 成立,语料里凡是同一对 e1、e2 同句出现的地方都被打上 r,而同一对实体在不同句子里聊的根本不是同一件事。第 05 篇会把这条噪声链路完整拆开。
预训练加微调
这一代把上限又推了一截(+BERT+BiLSTM → +Fine Tune),同时把两类新麻烦带到台面上。
标注噪声。 Wang 等的 CrossWeigh(EMNLP 2019)专门处理训练期间的标签错误,做法是划分数据集、独立训练 NER、识别潜在错误、调整训练数据权重。
事件抽取那边,Xu 等的 Tolar 把动机说得很直白:事件抽取是数据饥渴任务,真实场景里噪声标签无法避免,预训练语言模型几乎分辨不出噪声标签、很容易去拟合它们,噪声率超过 50% 时对性能的影响尤其显著。Tolar 用事件 schema 映射和自适应迭代两阶段矫正标签,并用协同全局指针网络(CoGPN)让两个 GPN 在小批量里互相挑出小损失样本当干净数据。
模型没法跟着数据走。 这催生了一批持续学习工作。
| 工作 | 场景 | 做法 |
|---|---|---|
| 原型网络(Liu 等,AAAI 2024) | 统一多场景持续 NER | seen 只用当前数据实时更新原型,unseen 用最新表示的平均值 |
| 知识共享:隔离的类型增量 NER 框架 | 类型增量 | 共享冻结的语言模型编码器,每个任务分一个独有投影网络,推理用最近邻分类 |
| 蒸馏做持续 NER(Monaiku 等,AAAI 2021) | 防灾难性遗忘 | 在新类型集合上表现好,同时在旧类型上不退化 |
| Online Noisy Continual Relation Learning(Li 等,AAAI 2023) | 在线流数据加噪声标签 | 先划分干净与噪声样例,再自监督在线学习、半监督线下微调 |
效率与结构问题
同一时期还有一条线在解决工程上的效率与结构限制。
| 工作 | 针对的问题 | 做法与结果 |
|---|---|---|
| FastRE(Li 等,IJCAI 2022) | 性能与效率的平衡 | 用膨胀卷积神经网络替代笨重的 PLM,引入关系类型映射机制,换来 3–10 倍训练加速、7–15 倍推理加速、参数量约为其他模型的 1/100 |
| PasCore(Wang 等,IJCAI 2023) | 中文重叠关系 | 对头节点用全局指针标注策略,综合关系和头节点类型去标注尾节点 |
| fmLRE(Wang 等,AAAI 2023) | 低资源 | 用基于特征映射相似度计算的迭代反馈提高伪标签正确率 |
检索增强
检索增强是这条时间轴的最后一格(2022,+Retrieval)。Wang 等的做法是把外部上下文检索回来重排,再用合作学习约束(CL-KL,ACL 2021)。
回头看,它是 Prompt 时代的前哨:模型参数之外的知识开始被正式当输入喂进来。
大模型这一段
Li 等的 SUMASK(EMNLP 2023)把零样本关系抽取的两条路线摆在一起:小语言模型走元学习(Meta Learning),大模型走 Prompting。Prompting 的毛病也点得很准:直接要求 LLM 通过指令从文本里抽关系标签,缺乏中间步骤,而这件事本身包含三个部分:抽取句中主客体之间的关系语义、理解每个关系标签的语义、把实体间关系语义与给定标签匹配。SUMASK 的做法是分别生成 k 个 [SUMMARIZE][QUESTION][ANSWER],用表示之间的离散度近似不确定性,取不确定性最低的关系作为最终预测;结论是它优于其他零样本基线,甚至优于部分全监督基线。
Li 等另一篇用表格化提示(tabular prompting)做关系三元组抽取(COLING 2024),认为 ICL 主要看两件事:prompt design(结构化提示更有利于 RTE)和 demonstration retrieval,原理是测量两个未标注样本中包含的三元组集合的相似性,再根据整个测试数据挑最具代表性的样本去标注。
NER 这边,Wu 等的 ConsistNER(AAAI 2024)指出 LLM 做 NER 的 ICL 由 Query Forms 和 Demonstration Retrieval 两部分组成,而后者有两个问题:缺乏本体一致性(Ontological Consistency)和缺乏上下文一致性(Contextual Consistency)。它的解法是先做预识别、再按本体过滤候选、再按句子级上下文检索示例。
Wang 等的 InstructNER(ACL 2024)走得更远:用 Stable Diffusion 合成图像,再用合成过程中产生的图文注意力矩阵副产品去引导图文细粒度软对齐,结论是合成图像取得了与真实图像相近的结果。
大模型时代还多了两件被专门列出来的事。
- 数据增强:用大模型生成合理的增强数据,去生成「本体和上下文保持」的 NER 样本、去合成图像。
- 幻觉与事实性:Shang 等的 OntoFact(AAAI 2024)根据知识图谱的事实性三元组构造问题,从知识图谱的本体视角出发评测大模型的事实性能力,并提出混合空间的强化学习机制来发现和评估事实性不强的领域数据。
注意这里的方向反了:以前是 KG 靠抽取来填,现在 KG 被用来给 LLM 做体检。
五、评测:数字、坑,以及谁来评
评测这一层分两截。
第一截:任务指标
NER 的时间轴给的就是 F1,从 85% 到 94.6%,这是整条方法线上唯一成体系的数字序列。抽取任务里的标准算法是:Precision = 抽对的条数 / 抽出的总条数,Recall = 抽对的条数 / 应该抽出的总条数,F1 是两者的调和平均;NER 通常按实体边界完全匹配才算对。这套定义到处都能查到,但它是读所有后续数字的前提。
第二截:抽取结果的质量评估
这是个独立问题,问的不是模型在测试集上多准,而是抽出来的这批三元组本身有多可信。
| 工作 | 做法 | 结果 |
|---|---|---|
| Gao 等(VLDB 2019) | 针对知识图谱准确率的二阶段带权聚类抽样 | 能减少 60%–80% 的评估时间,因为全量人工核对根本不可行 |
| Wang 等 | 一套系统性知识图谱质量度量:6 个维度、21 个评估指标 | 构建了 DBP600K-KQ 和 WD200K-KQ 数据集,揭示了 Wikidata 和 DBpedia 中存在的质量共性问题 |
坑主要来自三处
每一处都有证据可查。
- 标注不一致。 CrossWeigh 处理训练期标签错误;Tolar 的动机直接说 PLM 分不清噪声标签、会去拟合它们,噪声率超过 50% 时影响尤其明显。也就是说,你看到的 F1 里有一部分可能是在拟合错标。
- 同一事实的多来源冲突。 「中兴通讯:中国联通」在 2016.03.23 是「合作伙伴」、2015.06.12 是「客户」,抽取时若不带时间与来源,这两条就直接打架。
- 知识本身的性质。 这里并列了三个挑战:不明确性(ambiguous,Beetles/beetles/Beatles 这类拼写与大小写的混淆,以及 citizenOf/livedIn/bornIn 这类谓词本身边界模糊)、不完备性(incomplete,关系缺失、标签或属性缺失、实体缺失)、不一致性(inconsistent,exclusive labels 比如 alive/dead 不能同时成立,domain-range constraints 也可能被违反)。这些都是抽取任务先天带着的,不是实现 bug。
六、给工程选型的一份对照
把「知识抽取在大模型技术范式下的重新定义」和最后的挑战页放在一起看,构成一份相当具体的清单:知识密集型领域(西医、中医、生物医学、化工、军事)的知识构建需要领域专家深度参与;工业领域差别很大,大量 ERP、CRM 信息系统、数据异构严重、缺乏训练模型的语料;大量多模态场景(图像、视频、音频里的高价值知识);大量长尾和离散知识(老工人的生产经验、老中医的诊疗经验、警察破案经验、供应链知识),分布长尾、训练数据少、抽取困难且代价高;以及持续和终生的知识构建,最终要落到一套工具集和平台。
把这些和前面的方法线对起来,选型可以按场景分成六类。
| 场景 | 建议路线 | 依据 |
|---|---|---|
| 标注充足、类型稳定的通用任务(常见领域的人名 / 机构 / 地名识别、粗粒度关系) | 直接调 LLM 加 ICL | ConsistNER 已经把 NER 的示例检索讲透,SUMASK 说明零样本关系抽取能打平部分全监督基线,自己训的收益越来越薄 |
| 垂直领域 + 严格 schema + 高准确率(医疗、化工、军事那类) | 训模型或至少做微调 | 理由不是精度数字,而是这些领域要专家参与,而专家时间是最贵的资源;LLM 的零样本能力在长尾类型上不可靠 |
| 数据量极大、QPS 敏感 | FastRE 那条路 | 参数量 1/100、推理快 7–15 倍,这种量级的差距不是模型换代能自然抹平的 |
| 噪声是常态的数据(爬来的、自动对齐来的、业务系统灌进来的) | 先把标签矫正或质量抽样做进流程 | Tolar 和 CrossWeigh 都是这个思路,Gao 等的抽样能砍掉 60%–80% 的评估时间,性价比比换模型高 |
| 需要持续更新、类型会增量的场景 | 先读持续学习那几篇(原型网络、知识共享:隔离、在线噪声持续关系学习) | 不要指望每次重训 |
| 评测本身也要选 | 给 KG 做质量体检用 6 维度 21 指标那一套;给 LLM 治幻觉用 OntoFact 那类「用 KG 反向评测模型」的思路 | 后者现在反而更接近生产需求 |
还没解决的问题
还有一批问题至今没有答案:图是天然稀疏的数据、语义信息不足,怎么和传统推理技术融合;KGE 的低维向量不等于原始语义,但大量推理都建立在这上面;知识不全、错误和冲突普遍存在,阻碍推理进行;链接预测和实体分类无法满足很多应用场景;大规模知识推理任重道远。
还有一句更基础的评价:现有应用大多停留在浅层的可视化、查询、问答等辅助智能工作上,还没能在大量行业里明显提升生产效率。
回到开头那个问题
抽取的目标是一个完美的知识体系,而我们拿到的仍然是需要人不断收拾的近似物。范式一轮轮换过来,从写规则到标数据、从人工特征到表示学习、从微调到检索增强再到大模型提示,这件事没变。变的是每换一代,人需要亲手做的那部分又少了一点。