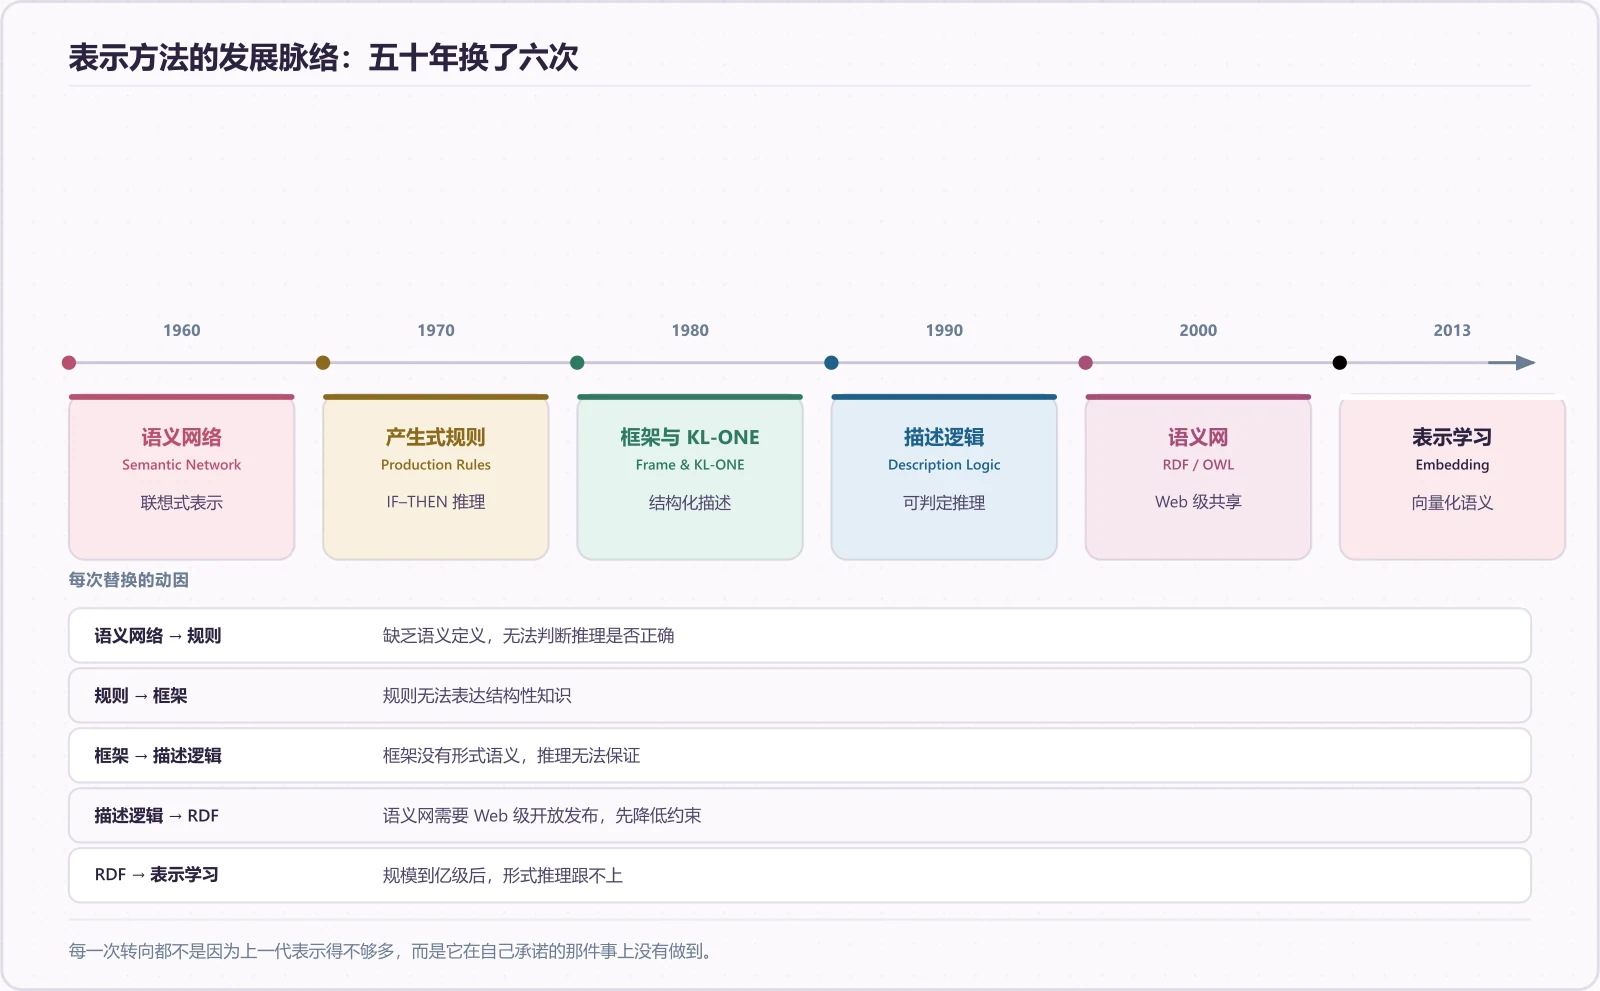
知识表示这一块的教材读下来会发现,它讲的不是「怎么把知识放进数据库」,而是表示方式互相妥协的历史。每一种表示被发明出来,都是因为上一代在某个承诺上没做到。
这一点对工程判断很有用。今天在选择 schema 的表达能力时遇到的那些取舍,五十年前就有人踩过一遍了。
一、知识表示要解决什么
定义有中英文两种口径,说的是同一件事。
中文教材的表述是:将关于世界的信息表示为符合机器处理的模式,用于模拟人对世界的认识和推理,以解决人工智能中的复杂任务。英文维基的表述是:knowledge representation and reasoning 致力于把关于世界的信息表示成计算机系统能用来解决复杂任务(例如诊断疾病、用自然语言对话)的形式。
两者的落点一致:表示的目的是让机器能算,不是让纸面好看。
这件事被两个学科同时管着。认知科学关心人类怎样储存和处理信息,人工智能关心怎样储存知识让程序能处理。AI 视角会追问几个问题:人类如何表示知识?某种表示法是领域专用还是通用?表达能力如何?应该是描述性的还是程序性的?最后一个问题正是后来「框架系统 vs 一阶逻辑」那条分岔。
按技术路线,表示方法大致分三类:基于非逻辑的、基于数理逻辑的、基于统计学习的分布式表示。在知识图谱的技术体系里,知识表示与知识建模、知识抽取、知识推理并列,同属知识层。它决定了整个系统能表达什么,因此是选型时最先要定的东西。
二、五种早期表示方法
从上世纪 60 年代到 90 年代,主流方法换了五次。每次替换的原因都很具体。
语义网络(Semantic Network)
节点表示事物、概念、情况、属性、动作、状态,每个节点可带若干属性;边表示语义联系,指明所连节点之间的关系。图表示和 LISP 表示各有一种典型写法。
优点是表示自然、易于理解、符合人类的联想记忆方式。不足有两条,而且都很致命:没有公认的逻辑基础,因此无法定义什么叫「推出结论」;网络形式过于灵活导致检索效率低,边可以任意连接,查询时无法利用结构做优化。
产生式规则(Production System)
行为规则的集合,一条规则包含前提(IF)和动作(THEN)。动物分类是经典例子:
R1:动物有毛                        → 哺乳类
R5:哺乳类 ∧ 动物吃肉                → 食肉类
R10:食肉类 ∧ 黄褐色 ∧ 有黑色条纹     → 虎
R14:鸟类 ∧ 会游泳 ∧ 黑白二色 ∧ 不会飞 → 企鹅
四个优点:自然性(符合人类表达因果的习惯,便于推理)、模块性(规则形式统一,易于模块化管理)、有效性(能表示确定性、不确定性与启发性知识)、清晰性(格式固定,便于对规则库做一致性与完整性检测)。
两个缺点:匹配规则代价高,求解复杂问题时容易组合爆炸;不能表达结构性知识。「不能表达结构性知识」这一条,正好是框架系统登场的位置。
框架系统(Frame System)
来自 Marvin Minsky 在 1974 年提出的思想:人对现实世界各种事物的认识都以类似框架的结构存在记忆中,遇到新事物就从记忆里找一个合适的框架,再按实际情况修改补充细节。
框架是知识表示的基本单位,是描述对象(事物、事件或概念)属性的数据结构。一个框架由若干「槽」(Slot)组成,每个槽又可分若干「侧面」(Facet):槽描述某一方面的属性,侧面通常是该属性的一个值。教学里常见的例子是给「男孩」和「猴子」各搭一个框架,把槽和侧面逐层填满。
优点是描述完整全面,并且允许数值计算,这在当时的表示语言里是少见的。不足是构建成本高、对知识库质量要求高,表达形式也不够灵活。
概念图与形式概念分析
这两支属于顺带收进来的旁支。
概念图(Conceptual Graph) 由 John F. Sowa 在 1976 与 1984 年提出,被称作一阶逻辑的图接口。示例写法是:
(exists ((x Sitting) (y Mat))
  (and (Cat Elsie) (agent x Elsie) (location x y)))
形式概念分析(Formal Concept Analysis) 由 Rudolf Wille 在 1982 年提出,用格(Lattice)和偏序集合描述概念结构。概念格由外延(实例集合)和内涵(属性集合)成对构成,被广泛应用在数据挖掘、机器学习与语义 Web 等领域。
把这几支放在一起看,能发现一条规律:画成图的样子好用,写成一阶逻辑的样子好推。 后来的描述逻辑要做的,是同时把这两件事要过来。
三、描述逻辑:两条路线之间
早期知识表示有两条路线,对比很清楚。
| 路线 | 代表方法 | 优势 | 代价 |
|---|---|---|---|
| 非基于逻辑 | 语义网络、框架系统 | 表达灵活,易于理解 | 没有明确的语义 |
| 基于逻辑 | 一阶谓词逻辑、Horn 子句 | 语义严格 | 推理复杂度高,半判定或不可判定 |
一边灵活但没有语义,一边有语义但算不动。描述逻辑(Description Logic, DL)就是冲这条缝去的,它的做法是各取一样:语法和语义从一阶逻辑那边取,表示的形式从语义网络和框架那边取。
具体而言,描述逻辑的语义可以化为一阶谓词逻辑,克服了语义网络和框架没有明确语义的缺点;同时它是一阶谓词逻辑的一个子集,改善了推理问题的可判定性与复杂性;又继承了语义网络和框架的表示特点,比一阶谓词逻辑更灵活、更易理解。
一阶逻辑那边有两个朴素的例子可以对照:对于每个 a,若 a 为哲学家则 a 为学者;存在一些人可以在任何时间被愚弄。Horn 子句(Horn Clause)由多个肯定的析取构成,是一阶逻辑的子集,也是 Prolog 语言的逻辑基础,在 AI 早期被用于自动定理证明,是当时最成功的应用之一。
描述逻辑的四个组成
| 组成 | 含义 | 例子 |
|---|---|---|
| 概念(Concept) | 描述世界的抽象术语 | 男人、人、丈夫 |
| 关系(Role) | 概念之间的联系 | 婚配于 |
| 实例(Individual) | 唯一的个体 | 张三 |
| 公理(Axiom) | 不证自明的命题 | 男人 是 人 |
这四个名字值得记牢,因为 OWL 里的类、属性、个体、公理是同一套东西的换名。语义上,概念解释为一元谓词,关系解释为二元谓词。「一元」和「二元」这两个词把概念与关系钉在了逻辑的地基上。
最小的命题封闭描述逻辑 ALC 由 Schmidt-Schauß 和 Smolka 在 1991 年提出。
TBox 与 ABox
知识库的形式是 TBox 加 ABox,定义很干净:
- TBox 表示术语公理,即概念之间的蕴含与等价关系
- ABox 表示断言事实,即陈述个体属于某个概念、以及个体之间的关系
换成工程语言,TBox 是「世界该怎么描述」的词汇表与规则,ABox 是「眼下是什么样」的具体事实。工程上说的 schema 与 instance,基本就是这两个词的另一种叫法。
推理问题
推理分两个层次。
概念推理有四个:概念满足(Satisfiability)、概念蕴含(Subsumption)、概念等同(Equivalence)、概念脱节(Disjointness)。后三个都可以转化为概念满足问题,反过来也可以。这意味着推理机只需要实现一个核心算法就够。四个问题看起来是四种能力,落到实现里只有一种。
个体推理有三个:一致性(Consistency)、实例检查(Instance checking)、检索问题(Retrieval problem)。
Tableau 算法是描述逻辑推理的主要手段:利用转化规则把原始问题展开为树结构,直到能判断命题成立或不可满足为止。它采用深度优先,总是先扩展最左分支;在完成态若存在一个无冲突分支,则结论为一致。
表达能力与推理代价的权衡
这句话被直接用作该领域发展史的标题。四个阶段:
| 阶段 | 时间 | 代表系统 | 特点 |
|---|---|---|---|
| 阶段一 | 1984–1991 | KL-ONE | 推理有多项式时间上限,但只对表达能力极弱的描述逻辑完备 |
| 阶段二 | 1984–1994 | CLASSIC | 采用表达能力受限的描述逻辑以保证推理几乎完备 |
| 阶段三 | 1991–1998 | FaCT | Tableau 提供完备推理手段,多数情况下有理想的复杂性 |
| 阶段四 | 1991– | 各种扩展 | 在应用需求驱动下研究表达能力更复杂的描述逻辑 |
这条演变线也是整个语义网技术栈命运的预告:描述逻辑被选作语义网的逻辑基础,而它天生带着表达能力的上限。
四、RDF:退回到只有三元组
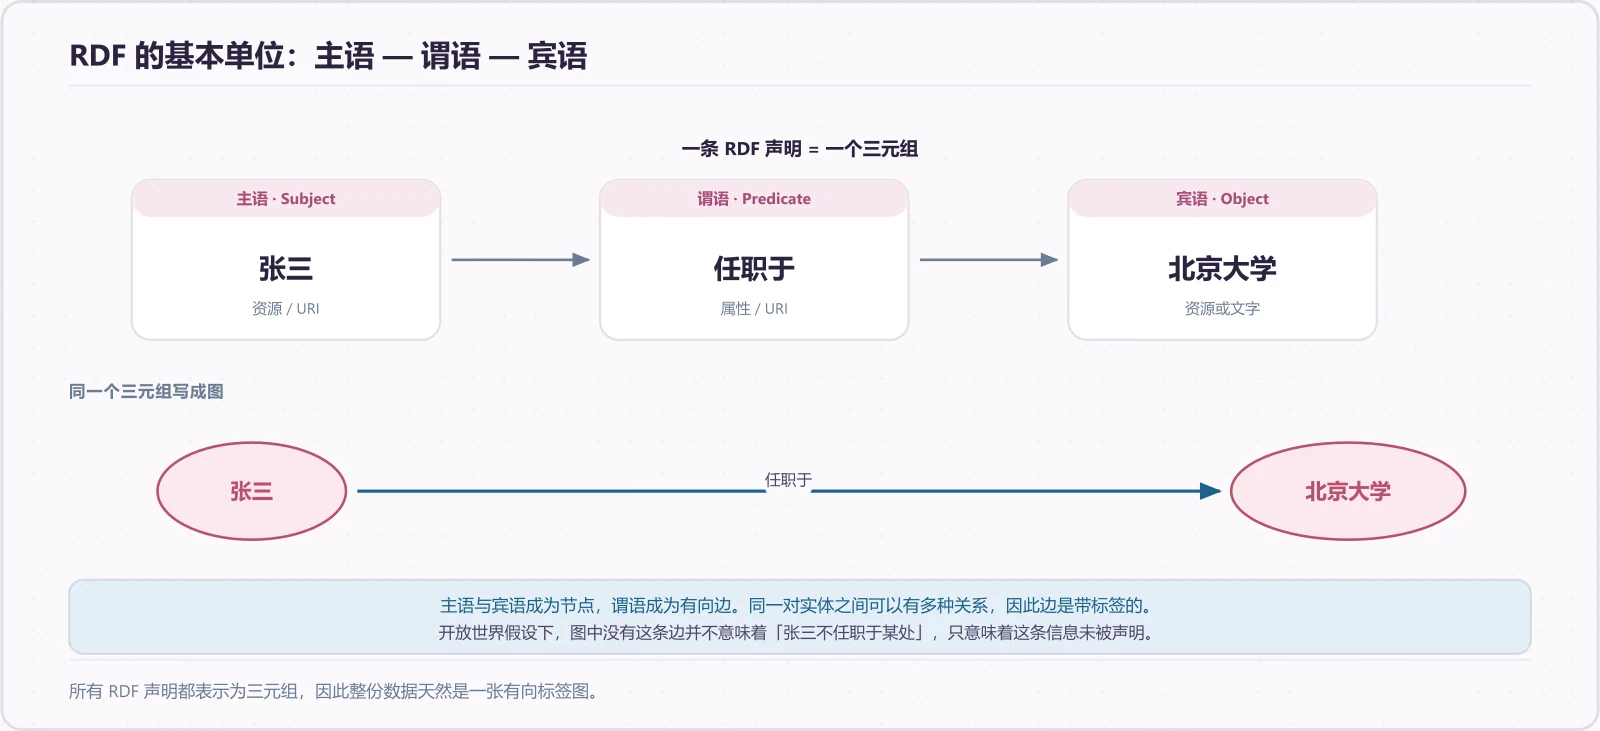
到这一层,主角换成 RDF(Resource Description Framework)。它的设计目的写得很克制:最低限度的约束,灵活地描述信息,可用于 Web。
五条设计选择:
- 采用基于三元组声明的图模型
- 基于 URI 的可扩展词汇集
- 基于 XML 的序列化语法编码
- 形式化的语义与可证明的推论
- 允许任何人发表任何资源的声明
第 5 条是语义网与传统数据库分野的地方,它对应开放世界假设:没说过的未必是假的。图谱里查不到「A 是 B 的老师」,不能推出「A 不是 B 的老师」。
这五条之间存在张力。第 4 条要求可证明的推论,第 5 条又允许任何人发表任何声明,两者同时成立时能证明的结论必然很少。RDF 的选择是把这份代价往后推。
RDF 模型与词汇集
四个基本概念:
| 概念 | 含义 |
|---|---|
| 资源(Resource) | 由 URI 标识的所有事物 |
| 文字(Literal) | 字符串或数据类型的值 |
| 属性(Property) | 描述资源的特征、属性或关系 |
| 声明(Statement) | 一个资源加上属性及属性值 |
所有 RDF 声明都表示为三元组。 词汇集的定义交给 RDFS:类 rdfs:Class、类层次 rdfs:subClassOf、实例定义 rdfs:type、属性定义 rdfs:range / rdfs:domain、属性层次 rdfs:subPropertyOf。
关于 Person 类的 RDF 描述如下(原样保留,未作改动):
<rdfs:Class rdf:ID="Person">
  <rdfs:comment>The class of people.</rdfs:comment>
  <rdfs:subClassOf
      rdf:resource="http://www.classtypes.org/useful_classes#Animal"/>
</rdfs:Class>
<rdf:Property ID="name">
  <rdfs:comment>Person Name</rdfs:comment>
  <rdfs:range  rdf:resource="http://www.datatypes.org/useful_types#USAddress"/>
  <rdfs:domain rdf:resource="#Person"/>
</rdf:Property>
上面
name属性的注释写的是 Person Name,值域却指向 USAddress,看起来是材料本身的笔误,此处照抄未改。
RDF 的六条不足
这六条读起来像缺陷清单,实际上它就是 OWL 的需求文档。
| # | 不足 | 具体表现 |
|---|---|---|
| 1 | 值域定义是全局的 | rdfs:range 无法说明该属性应用于某些具体类时的特殊值域限制 |
| 2 | 无法声明等价 | 无法声明两个或多个类、属性、个体是等价还是不等 |
| 3 | 无法定义不相交类 | 只能声明子类关系,无法声明「男人」与「女人」这两个类不相交 |
| 4 | 无法用布尔运算构造类 | 无法通过并、交、补构建新类,例如把「人」定义为「男人」与「女人」的并 |
| 5 | 无法表达基数约束 | 无法说明一个人有双亲(恰好两人)、一门课至少有一名教师 |
| 6 | 无法描述属性特性 | 无法声明传递性、函数性、对称性,也无法声明逆属性 |
把六条和 OWL 后来的能力对照着读会发现,OWL 的类构造和属性特性几乎是在按这份清单逐条实现。
五、OWL:补上语义,也补上复杂度
OWL(Web Ontology Language)的设计思想有三条:
- 扩展 RDFS,语法规则采用 RDFS/XML,语义严格遵循描述逻辑
- 根据应用对表达能力与推理复杂度的不同要求,提供 OWL DL 与 OWL Lite 两种子语言
- 为完全兼容 RDFS 提供 OWL Full,它包含 OWL DL 的全部内容,但也导致 OWL Full 的推理问题不可判定
第 2 条里的两种子语言不是并列关系:DL 表达能力更强,Lite 往更小、更好实现的方向退;它们和 Full 一起,刚好落在「严格但受限」与「宽松但不可判定」这两个极端之间。
第 1 条和第 3 条合起来看才是这层设计的核心矛盾:OWL 的语义来自描述逻辑,而描述逻辑的价值就在可判定性;一旦为了兼容 RDFS 而放开限制变成 OWL Full,可判定性就失去了。OWL Full 的问题不在于更强,而在于它同时要 DL 的严格语义与 RDFS 的无限语法,这两件事本来就不可兼得。
OWL2 的定位延续了这个思路:定义 OWL 的子语言,通过限制语法使用,使这些子语言更方便实现与应用。
各层次的能力与代价
| RDF | RDFS | OWL(DL / Lite) | OWL Full | |
|---|---|---|---|---|
| 基本单位 | 三元组声明 | 三元组 + 词汇集 | 类、属性、个体、公理 | 同 OWL DL,语法不受限 |
| 能表达 | 事实与关系 | 类层次、属性层次、domain/range | 等价、不相交、并交补、基数约束、传递/函数/对称/逆属性 | 无语法限制 |
| 类不相交 | 否 | 否 | 是 | 是 |
| 基数约束 | 否 | 否 | 是 | 是 |
| 语义基础 | 图模型 | 图模型 | 严格遵循描述逻辑 | 失去可判定性 |
| 推理 | 图匹配 | 子类 / 子属性传递 | 有完备推理手段(Tableau 一类) | 不可判定 |
横着读是能力递增,竖着读是代价递增。能表达的东西每多一项,推理要付的账就多一笔,到 OWL Full 那一列干脆不再承诺能算完。
查询与序列化
查询语言是 SPARQL:基于图匹配模型,使用 SELECT-FROM-WHERE 句式,并增加了图算子 OPTIONAL。
OPTIONAL 是开放世界假设的直接后果。图谱里缺一条边是常态,查询语言必须内建「匹配不到也算数」的写法,否则大多数查询都会因为某个可选字段缺失而整体失败。
把 SPARQL 归到「图匹配」这一档,也解释了它为什么不需要推理机:它查的是图里显式存在的边,不做蕴含。RDF 这一层从头到尾守的是同一个承诺:先说清楚有什么,再谈能推出什么。
JSON-LD(JSON for Linked Data) 提供一种用 JSON 语法描述有向图、并在一个文档中混合表示互联数据与非互联数据的方式。它在 JSON 语法基础上提供规范的术语(本体)表示,使术语的理解不再依赖猜测,机器因而能直接处理。
JSON 与 JSON-LD 并排看,差别很清楚:前者是数据形状,后者加上了术语的确定性。这一步的意义常被低估。前几种表示改的都是数据的形状,JSON-LD 改的是术语有没有唯一含义。
六、表示学习:表示最终变成向量
最后一个方法是统计表示学习。两种表示方式对比:
| 传统符号表示 | 统计学习表示 | |
|---|---|---|
| 形式 | 基于符号的三元组 | 分布式向量 |
| 能否捕获语义关系 | 不能,显式与隐式关系都难以表达 | 能,尤其是隐式关系 |
| 与机器学习模型的配合 | 不便直接使用 | 向量形式可直接输入模型 |
| 语义可计算性 | 否 | 是 |
类比来自自然语言处理:Word2Vec、Doc2Vec 的表示结果处在统一的语义空间中,语义因此变得可计算。这一转向的时间点是 2013 年前后,具体原理与例子在第 08 篇展开。
七、这些设计留下的东西
schema 与实例为什么要分开
TBox/ABox 这套划分在工程上有一个直接理由:两者的变更代价不是一个量级。
TBox 动一个类层次,可能影响成百上千条已有事实的语义。把「导师」从非对称改成对称,全图会推出一批新结论,其中一部分是错的。ABox 加一条边基本是廉价的,失败了删掉即可。
这决定了两者的流程不同:schema 需要评审和版本化,三元组则可以流水线灌入。
最小约束这个选择被反复继承
RDF 那句「最低限度的约束」听起来像妥协,但后来几乎所有图数据模型都遵循同一个顺序:先让数据进得来,再谈约束。
代价是质量问题只能靠下游的推理、规则或人工校验去补。这个代价是真实存在的,不是可以忽略的。
可判定性是被牺牲掉的那一项
工程上的常见答案是两边各留一点:用接近 DL 的方式约束 schema,但不指望推理机跑全量推理。schema 里的公理更多是给人看的约束说明,而不是交给推理机执行的任务。
JSON-LD 可能是这一层里最实用的技术
在普通 JSON 里加一个 @context 让术语有唯一含义,比 OWL 那套更容易被业务系统接受。今天大部分知识图谱的对外开放接口用的都是 JSON-LD,而不是直接的 RDF/XML。
回头看这几层的关系,是一套分工:RDF 负责让数据进得来,RDFS 给词汇一点结构,OWL 负责严格的那部分语义。没有哪一层打算把所有事都做完。
八、这一路到底在权衡什么
把这一路拉通看,只有一个变量在反复被调:表达的野心和推理的代价。
| 方法 | 想要什么 | 结果 |
|---|---|---|
| 语义网络 | 自由表达 | 既没有语义,也没有效率 |
| 一阶逻辑 | 精确 | 不可判定 |
| 描述逻辑 | 两者折中 | 靠限制语法换回可判定性 |
| RDF | 先让数据进得来 | 约束压到最低 |
| OWL | 严谨与可用之间再找一点 | OWL Full 放弃可判定性 |
| 表示学习 | 规模上可用 | 放弃符号推理,换成向量 |
等知识规模涨到亿级,任何形式化推理都跟不上,这条路自然就拐向了向量。
工程上实际要做的三件事
学这一块不必期望背完就会用。真到工程上,日常要决定的只有三件事:
- schema 怎么定:用多少类、哪些关系、层次多深
- 约束写到什么程度:走到 RDFS 就够,还是需要 OWL 的等价与基数约束
- 什么时候放弃形式推理。规模上来之后,把推理换成规则匹配或统计方法
剩下的细节,比如 Tableau 怎么展开、ALC 的语义表长什么样,需要的时候再回去补,不影响把系统搭起来。