建模是知识图谱项目里最便宜也最贵的一步。
便宜是因为它不产生数据:列出几十个类、定义十几条关系,一天就能出一版。贵是因为它决定了后面所有事情的范围:抽取要抽什么关系、查询能问出什么、推理能推出什么。schema 定错之后再改,已有的三元组往往需要重新对齐。
这篇文章讲清楚三件事:本体到底是什么、它和数据库 schema 的实际差别、以及建模时那几个会决定后续工作量的问题。
一、本体是什么
计算机科学里的定义是这样:本体(Ontology)是领域共享知识的描述方式,是语义 Web、语义搜索、知识工程与许多人工智能应用的基础,由概念、实例、关系三部分构成。
引用最多的一句出自 T. R. Gruber(1993):
In theory, an ontology is a "formal, explicit specification of a shared conceptualisation".
另一处常见表述是:在计算机科学与信息科学中,本体是「把知识形式化表示为一个领域内的一组概念,以及这些概念之间的关系」,用来对该领域内的实体进行推理,也可以用来描述这个领域。应用范围包括人工智能、语义网、系统工程、软件工程、生物医学信息学、图书馆学、企业书签与信息架构。
用更直白的话说:本体是告诉计算机「人类怎样理解某个领域」的形式化描述。 它不存事实,它规定事实可以怎么被描述。
一条哲学上的提醒
本体这个词来自哲学。柏拉图在《理想国》里讲过洞穴寓言:存在一个不依赖人类认识的外在知识体系,人只能不断从现象中推测它,注定不断接近却达不到。
这段放在技术文章里看似离题,但它对应一个具体的工程预期:schema 定不到完美。 认为"本体应该一次定对",会导致两种失败。一种是反复推倒重来,项目停在建模阶段出不了数据;另一种是拍脑袋定完再也不动,跑到一半发现结构性缺陷。
Ontology Development 101 里有一句对应的表述:随着开发进行,这些问题和它们的回答可能发生变化,这时需要考虑什么时候回到第一步迭代。建模是循环的,不是一次性的。
二、本体和数据库 schema 差在哪
从后端转过来的人几乎都会问这个问题。差异可以列成一张表。
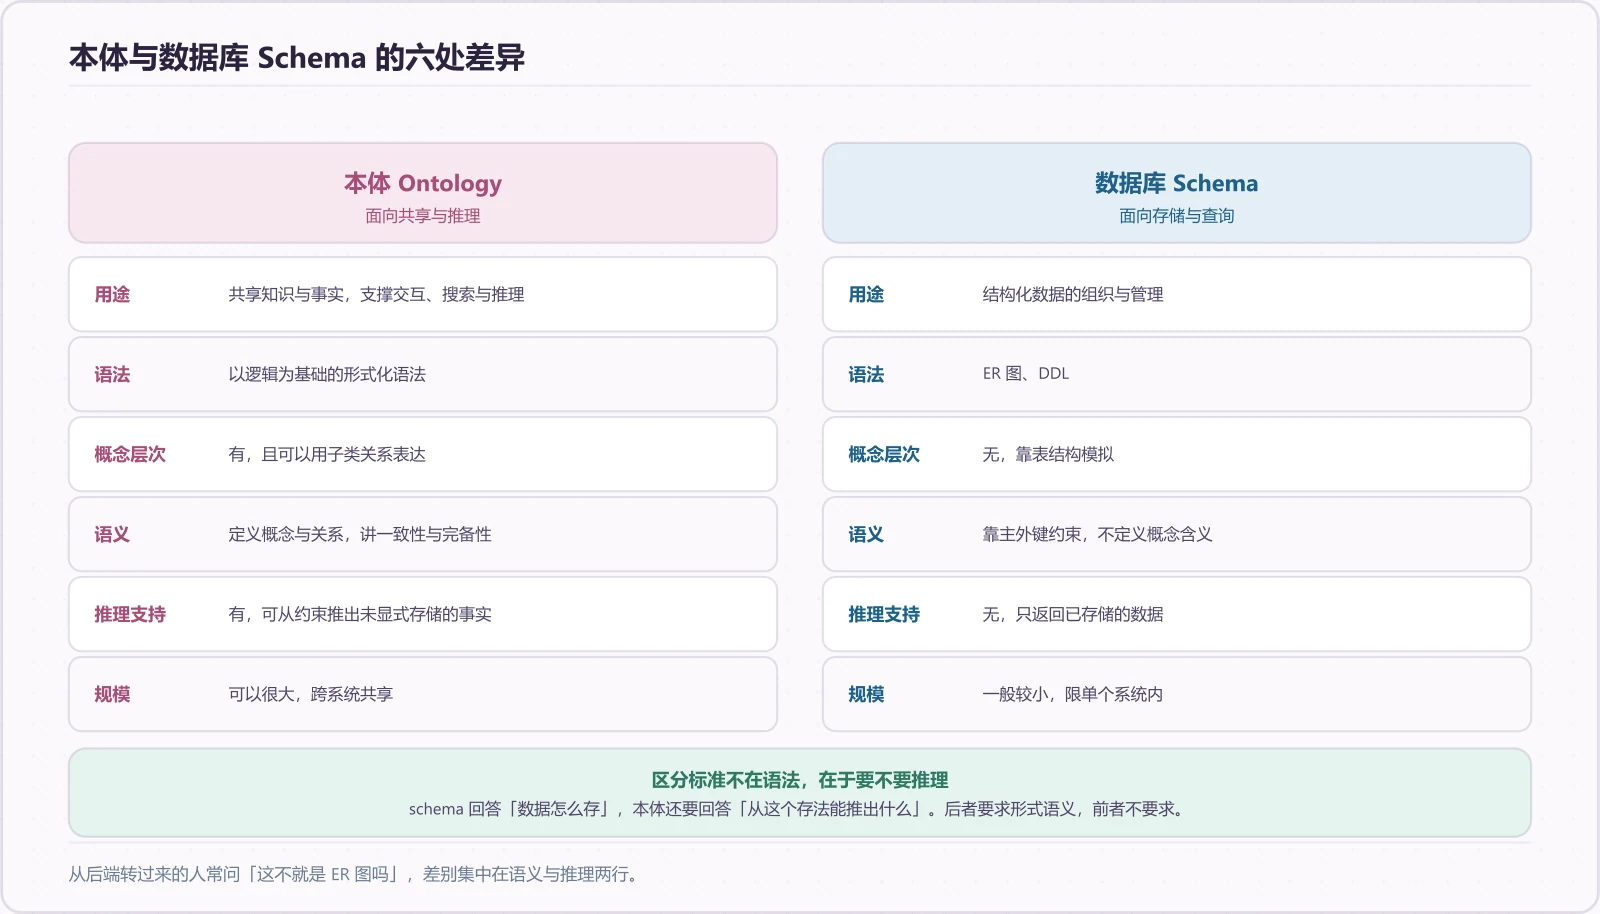
分界在最后两行:语义与推理。
数据库的 schema 回答的是「数据怎么存」,它保证数据完整性和查询效率,不定义概念的含义。你可以在 users 表里加一个 birth_city 字段,但数据库不知道「城市」和「省份」是什么关系,也不知道一个城市只能属于一个省。
本体还要回答「从这个存法能推出什么」。这要求形式语义,因为推理必须建立在严格的定义上,否则推出的结论没有保证。
举个具体差别。假设本体里定义:
父亲的 domain = 人物
父亲的 range   = 男人
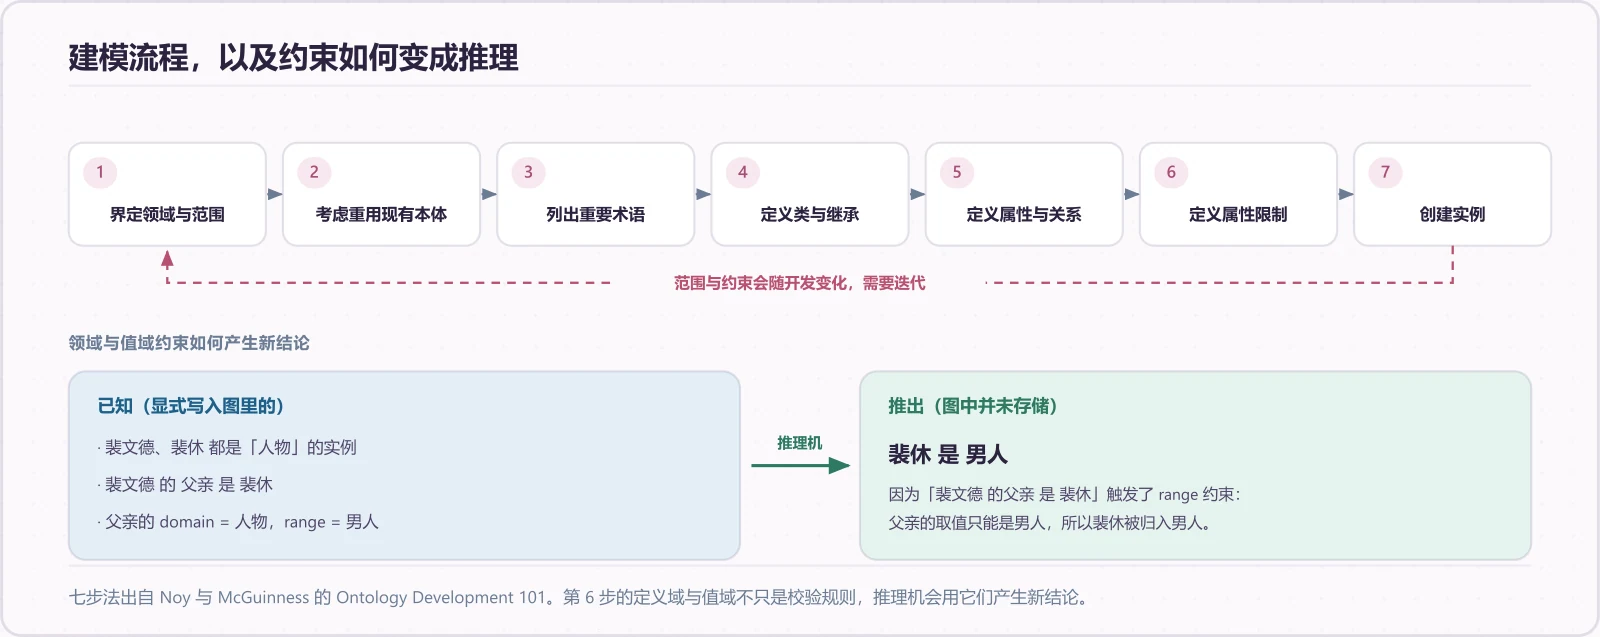
图里只存了两条事实:「裴文德 是 人物」「裴文德 的父亲 是 裴休」。推理机读到第二条,发现「父亲」的值域要求是男人,于是把裴休归入男人这一类。注意图中并没有任何一条断言说裴休是男人。
数据库做不到这件事,因为它的外键约束只用于校验,不用于推断。这个例子在下面第五节的图里会再出现一次。
三、本体长什么样:两个例子
考拉与桉树
本体是「世界的某个侧面的一个模型」,它做两件事:引入领域词汇表(Anatomy、Aerospace、Koala 等),以及规定术语的语义。
一个最小例子是两条语义说明:
Koala eat only some part of Eucalypt
Eucalypt is Plant
这里的 only 和 some 不是修辞,它们是可以被机器使用的量词约束。「考拉只吃桉树的某些部分」和「考拉吃桉树的某些部分」对推理机来说是两个不同的命题:前者排除了吃其他东西,后者没有。
内在属性与外在属性
属性建模的例子更具体。联系分两种。
内在属性指概念自身的属性,例如概念 Wine 的味道,用术语 Flavor 表示。这类属性通常把一个概念和一个值连起来,在 OWL 中表示为 DatatypeProperty。它有两个特征:具备通用性,该类的所有实例都有这个属性;能向下传递,父类有内在属性时所有子类继承。
由此推出一条明确的建模要求:一个属性应该为拥有该属性的最大类所拥有。
外在属性有的文献直接称为关系,用于连接不同概念的实例。例如概念 Worker 的外在属性 Workfor 连接概念 Company,表示分别来自这两个概念的实例之间可能存在雇佣关系。在 OWL 中表示为 ObjectProperty。
这条区分把「属性该挂在哪一层」从一个画图习惯变成了有确定答案的工程约束。挂错了层级会导致两种后果:挂太低,兄弟类无法复用该属性,需要在每个子类重复定义;挂太高,不属于该类的实例也被赋予这个属性,产生无意义的边。
四、建模方法:七步流程
建模方法论有不少种,Noy 与 McGuinness 提出的七步流程是最常被引用的一套(出自 Ontology Development 101)。骨架法、IDEF5、TOVE 等方法不在这里展开。
| 步骤 | 要确定什么 |
|---|---|
| 1. 界定领域与范围 | 本体针对什么领域、用途是什么、要描述什么信息、回答哪一类问题、谁来使用和维护。这一步通常借助能力咨询(competency question)获得 |
| 2. 考虑重用现有本体 | 能精炼、扩充、修改现有的,可以省掉大量工作;即使现成本体不满足要求,通常也能提供启发 |
| 3. 列出重要术语 | 列出建模感兴趣的事物、属性与关系,保证最终本体不偏离领域 |
| 4. 定义类与继承 | 检查继承是否正确、分析兄弟类、确定引入新类的时机、判断用类还是用属性值、区分实例与类、设定范围限制、声明不相交的子类 |
| 5. 定义属性与关系 | 含逆属性与缺省值,即上面内在属性 / 外在属性的区分 |
| 6. 定义属性限制 | 属性的基数、属性值的类型、属性的定义域与值域 |
| 7. 创建实例 | 确定与个体最接近的类,把个体添加为该类的实例,并为属性赋值 |
第 4 步的继承结构可以自顶向下(从最大概念开始加子类细化)、自底向上(从最细的类开始找父类),也可以两者结合。
第 1 步结尾有一句需要记住:这些问题和回答可能随开发变化,此时需要回到第一步迭代。 这是整个流程里唯一明确写着「回头」的地方。
命名规则
命名规则比步骤本身更容易被忽视,但它一旦确定就必须严格执行。需要事先决定:系统对大小写是否敏感、用单数还是复数、前后缀与分隔符怎么用。
有一条硬性要求:不能把 Class、Property、Slots、Relation 这类建模元语当作术语塞进概念名里。
Class_Wine_Property 这种命名看起来严谨,实际是用元数据污染了领域词汇。后果在实体对齐阶段暴露。当需要把这个本体和外部本体合并时,概念名里的元语会干扰字符串匹配与语义匹配,而且无法通过配置消除。
五、五步实践流程与三条原则
除了七步法,还有一套更贴近工程落地的五步流程。
步骤一,查阅资料了解领域。 先弄清这个领域里到底有什么。
步骤二,重用现有图谱。 这一步的要求比较硬:一定要学习、分析和重用现有经典知识图谱中的相关知识,尽量不从零构建。可参考的图谱包括 DBPedia、YAGO、BabelNet、ConceptNet、ConceptGraph、Zhishi.me、CN-DBPedia、Google Knowledge Graph、NELL 等。做法是总结其中可重用的知识,并且用实例去检验构建的知识是否完备和合理。
步骤三,设计本体。 有三条原则:
| 原则 | 内容 |
|---|---|
| 描述范围与简洁的平衡 | 全面描述重要知识,同时保证本体精炼;本体内部要有较好内聚性,与其他知识有明显区分,保持模块间低耦合 |
| 概念精炼 | 当属性的值域在概念与数值之间难以确定时,优先选择数值,尽量减少概念的生成 |
| 对象属性优先 | 对象属性用于建立实体间关联,本体构建中应优先考虑 |
设计过程的顺序是:术语 → 概念 → 属性 →(公理、实例)。具体动作有四组:确定规范术语;确定概念层次;确定值属性、对象属性、属性层次与属性公理。
步骤四,请领域专家审核。 常见讨论集中在三点:分类体系、术语收集、属性。
步骤五,本体实现。 建模工具可以用 Protégé、Excel、CSV;表示形式可以用 RDF、三元组、JSON-LD。
六、本体学习:不想手写时的两条路
本体通常手工构建,但概念与层次的候选可以自动获取。两条主要路线:
| 路线 | 做法 | 优点 | 缺点 |
|---|---|---|---|
| 基于规则 | 人工写模板规则抽取 | 能把专家知识写进抽取模板 | 规则不足、规则冲突、不好扩展 |
| 基于机器学习 | 转为分类或序列标注问题,选特征与模型训练 | 效率高、自动化 | 模型通用性与学习效果之间存在矛盾 |
基于规则这条路里最经典的是 Hearst 的工作:Hearst M A. Automatic acquisition of hyponyms from large text corpora. ACL 1992,即今天所说的 Hearst Patterns。它的思路是用一批固定的句式模板,从大规模语料里自动抽取上下位词对。后续有 Roller S, Kiela D, Nickel M. Hearst patterns revisited: Automatic hypernym detection from large text corpora. ACL 2018,关注点是上位词检测、概念上下义、等价与 is-a 关系。
七、工具与一次完整的建模演示
最常用的建模工具是 Protégé,由斯坦福大学开发。它有四项功能:
| 功能 | 说明 |
|---|---|
| 类建模 | 建立类与类的层次结构 |
| 实例编辑 | 从类自动生成交互式表单,让领域专家可以直接编辑实例 |
| 模型处理 | 插件库可定义语义、解答询问、定义逻辑行为 |
| 模型交换 | 模型能以 XML、UML、RDF 等格式装载与保存 |
一个完整的演示以中国佛教人物为领域,操作顺序与七步法基本对应:
- 构建类
- 构建子类
- 构建类之间的关系,其中专门声明了「人物」与「地点」的 Disjoint(不相交)关系
- 构建对象属性,做的是「曾住」,含定义域与值域
- 构建数值属性,做的是「法号」
- 构建实例,例如「佛印禅师」
- 可视化
- 推理
推理那一步的结果值得完整看一遍:
已知:
1. 裴文德和裴休都是「人物」的实例
2. 裴文德的父亲是裴休
3. 「父亲」的 domain 是人物,range 是男人

推出:
1. 裴休是男人
图中没有任何一条断言说「裴休是男人」,但定义域与值域的约束加上一条父子关系,推理机自己把它推了出来。这是本体与数据库 schema 最直观的分野。
八、五个常见失败模式
1. 指望本体自动长出来
知识图谱分本体层与实例层,本体通常手工构建,实例通常自动化抽取。这是分工,也是预期管理。把本体也交给自动化,结果通常是概念层次混乱、无法解释。
2. 本体与业务脱节
这条反过来读就是本体的目的:构建本体是为了确定知识图谱能描述的知识。
失败的典型形态是本体描述的范围与项目要回答的问题对不上。图建得再规范,也没有人去查。这也是能力咨询存在的理由:先写清楚要回答哪一类问题,再决定建什么类。
3. 一开场就过度建模
有三条容易让人意外的表述:不一定需要本体的形式化表示;不一定需要 Protégé 等专业建模软件;不一定要把本体存储在数据库,可以在程序中直接使用。
它们针对的是同一种情况:为了"规范"先去啃 OWL、先搭一套推理机,结果几个月没抽出第一条数据。本体的规模应该由要回答的问题决定,而不是由理论上的完备性决定。
4. schema 定完再也不动
这是前一个失败模式的反面,同样致命。抽取跑到一半发现「人物」和「地点」没有声明不相交、或者属性挂错了层级,改一次就要重跑全量抽取与存储。
5. 值域定义写得过宽
用佛教人物那个例子可以看清代价。假设把「父亲」的定义域写成「人物」、值域写成「男人」,那么「裴文德的父亲是裴休」这条数据一进来,裴休就会被推成男人。如果当初把值域写成「人物」,什么都不会发生。
区别在于后续能力:想查「某位禅师的父亲是谁」、想按性别统计,前者可以直接查询,后者需要回去补断言或者改本体重新推一遍。一条值域定义决定的是后面所有查询能不能写出来。
九、本体的定位
最后一句定位讲得很清楚:本体是给知识图谱实施者使用的,通过它确定知识抽取的范围、推理规则、构造查询。
它不是交付物,是内部规约。这个定位决定了它的详细程度:够用即可,不以完整为目标。
十、大模型时代,本体还要手工建吗
一个合理的判断是:手工建的部分会缩小,但不会消失,而且位置会变。
会缩的是「从零列出全部概念和层次」。 本体学习的两条路线(规则模板、把本体学习当作分类或序列标注)本身就是在自动化这件事,语言模型把这条路的起点抬高了一截。以前要靠 Hearst Patterns 逐条抠上下位词,现在可以直接拿领域文本让模型提候选概念与关系,由人筛选。
不会消失的是三件事:范围界定、约束定义、与领域专家对齐。
七步法的第 1 步(能力咨询:这个本体要回答哪一类问题)和第 6 步(基数、值类型、定义域、值域)都不是文本挖掘问题,而是决策问题。前面那个推理例子同样说明了这一点:模型可以生成「裴文德是裴休的儿子」这样的断言,但「父亲的 range 是男人」需要有人拍板。拍错了,整张图的推理结果都会跟着错,而且从单个三元组上看不出异常。
领域专家审核被单列成一步,作用也不只是礼节性评审,而是防止本体变成建模者自说自话的机制。
归纳起来:语言模型能承担第 3 步(列术语)和第 7 步(造实例),第 1 步和第 6 步仍然需要人来做决策。