搜索一件事的时候,你可能遇到过两种结果。
一种是返回一段和问题「很像」的文字。它确实相关,但不一定回答了你问的东西,而且你无法确认它说的时间、数量、关系是否准确。
另一种是直接给出结构化的事实:某个人的出生地、某家公司的创始人、某个药物的适应症,并且能顺着关系往下追问一层。问「这家公司的创始人还创办了什么」,它会沿着「创始人」这条边走到另一个人,再展开。
这两种结果背后是两套不同的技术。前者通常是向量检索,后者是知识图谱。它们不是新旧替代的关系,而是解决不同层次的问题。这篇文章先把知识图谱的位置画清楚,后面八篇再逐层展开具体技术。
一、它要解决的核心问题
有一个很朴素的观察:文本能表达的信息量很大,但机器无法直接对它做运算。
「张三 2020 年加入北京大学,2023 年转到清华大学」这句话,人读完就知道了三件事:张三、这两所学校、以及两段有时序的任职关系。但把它存成一段字符串,机器能做的只有查找和相似度比较。它不知道「北京大学」和「清华」是同类事物,不知道「加入」和「转到」是同一种关系的两个实例,也没法回答「谁在两所学校都待过」。
知识图谱做的事情,是把这类信息改写成机器能运算的形式:
张三      就读于     北京大学
张三      就职于     清华大学
北京大学  位于       北京
清华大学  位于       北京
每一行是一个「实体 — 关系 — 实体」的三元组。写成这种形式之后,可以做的事就多了:查「哪些人在同一个城市的两所学校任职」变成一个可以顺着边走两跳的查询;「张三在哪座城市工作」可以通过「就职于」再走「位于」推出来,而不需要事先把答案存好。
这里有个关键区别值得先说清楚:顺序和因果是人读文本时补上的,图里必须显式写出来。 上面两段任职的先后顺序,在纯三元组里并没有表达出来,需要额外加上时间信息,否则图只能告诉你「张三和这两所学校都有关系」,说不出先后。这是知识图谱工程中反复出现的一类问题,后面讲事件抽取时会专门展开。
二、它和向量库的分工
「有了向量库还需要知识图谱吗」是入门时最常问的问题。答案是两者解决不同层次的需求,判断方法看问题的类型。
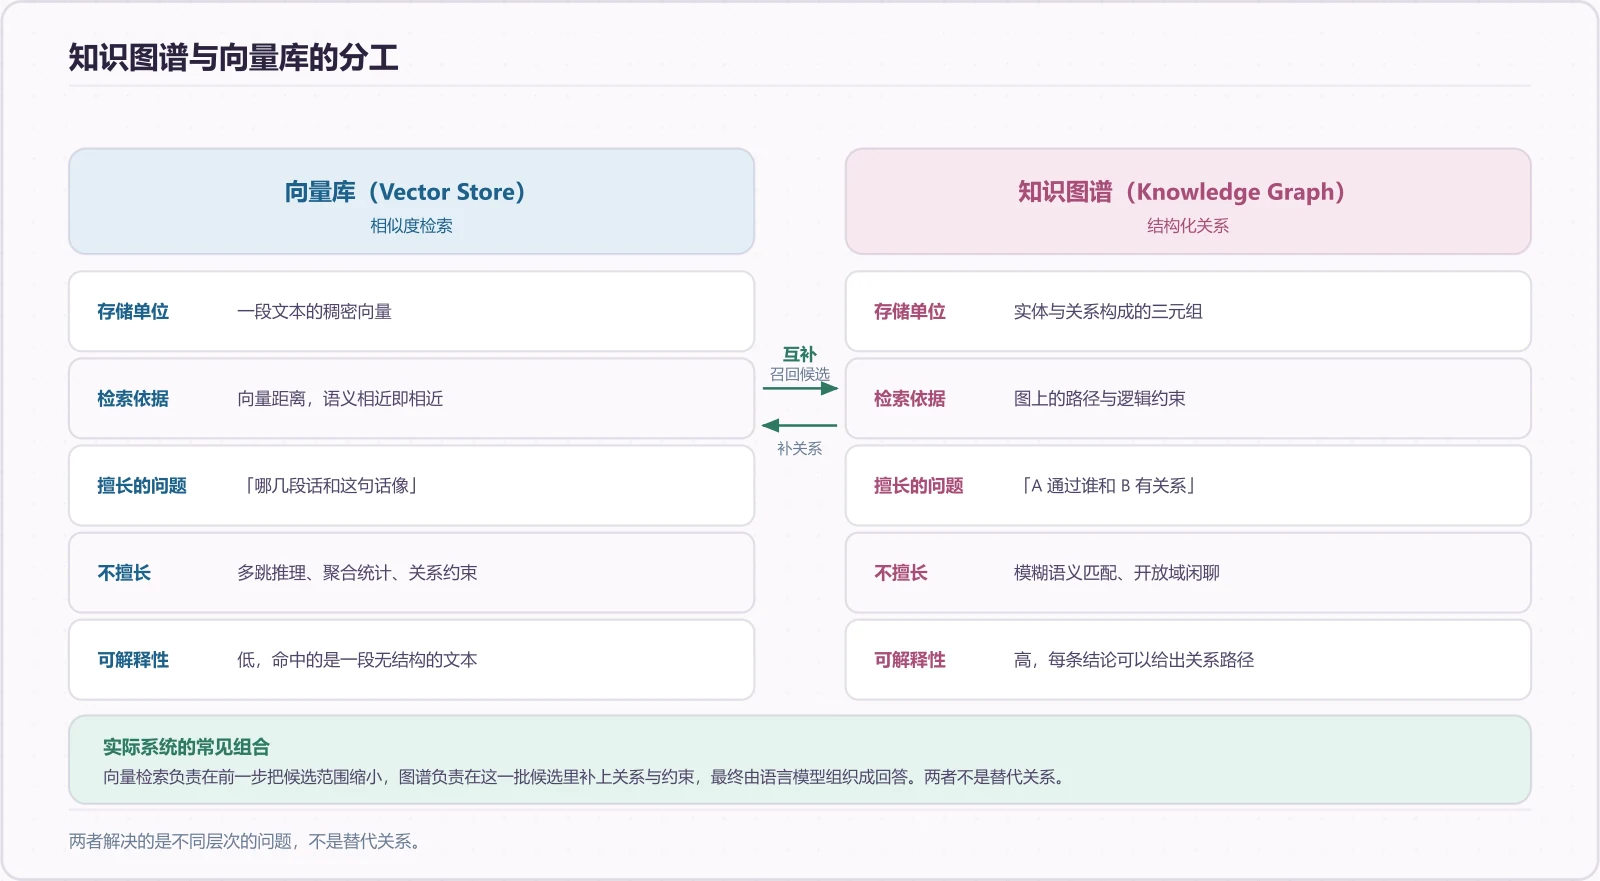
向量库把一段文本编码成一个稠密向量,检索时比较向量距离。它的强项是模糊语义匹配:「这段文字和哪几段话意思接近」,这个问题它做得很好,而且不需要预先定义任何结构。
它不擅长的是三类问题:
| 问题类型 | 例子 | 向量库为什么做不好 |
|---|---|---|
| 多跳关系 | 甲公司的投资方的创始人的母校 | 每多一跳,语义就远离原始问句一次,向量距离失去区分度 |
| 聚合与统计 | 有哪些作者同时发表过这两个主题的论文 | 相似度是检索机制,不是计数机制 |
| 关系约束 | 只找出有直接上下级关系的两个人 | 向量里没有「直接关系」这个概念 |
知识图谱在这三类上有优势,因为它存的就是关系本身。反过来,它在开放域闲聊、模糊匹配上不如向量库,因为图里没有的边就真的查不到。
工程上的常见组合是让两者配合:先用向量检索把候选范围从百万级缩到几十条,再用图谱在这一小批候选里补上关系和约束,最后由语言模型组织成回答。这个组合通常被称为 GraphRAG,第 08 篇会展开。
什么情况下不该用知识图谱
这一条同样重要。以下场景建图谱的投入往往收不回成本:
- 数据量很小,几百条事实用表格加几个查询就够了,建图反而增加维护负担
- 问题以模糊匹配为主,比如「帮我找几篇相关的文章」,向量检索更快更简单
- 关系不稳定且时效性极强,今天建好的边明天就变了,维护成本高于收益
- 没有可靠的抽取来源,纯靠人工录入的话,图谱的规模很难上去
知识图谱的收益来自「关系可以复用」。如果每个问题的关系都不同、用一次就丢,那就没有复用的价值。
三、一条完整的链路
理解技术分层最直接的办法,是跟着一句话走完全程。
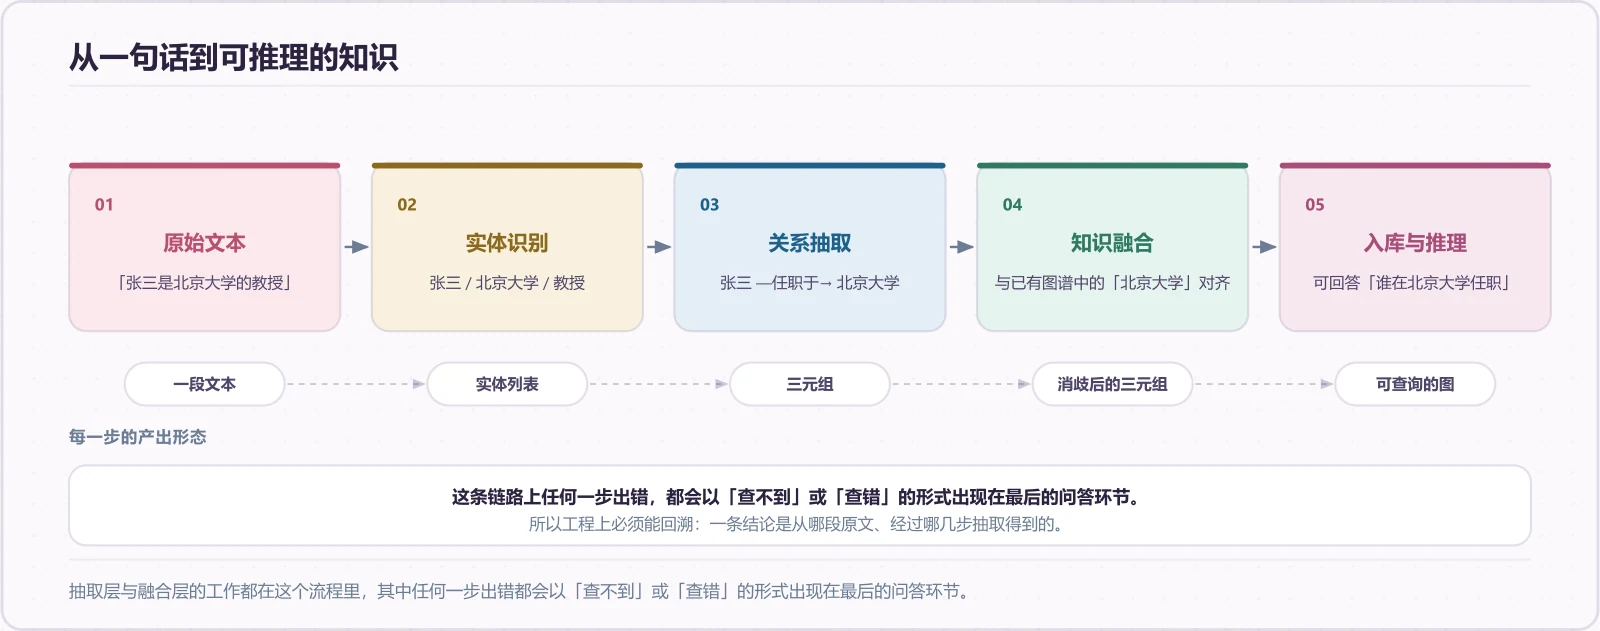
第一步是原始文本。 「张三是北京大学的教授」这句话本身不能直接查询。
第二步是命名实体识别,把句中指称实体的片段找出来并分类。结果是三个实体:张三(人物)、北京大学(机构)、教授(职称)。这一步的难点不在识别出「张三」这两个字,而在于判断它属于哪个类别,以及区分同名的不同实体。第 04 篇专门讲这个。
第三步是关系抽取,判断实体之间存在什么关系。这里得到的是「张三 — 任职于 → 北京大学」。难点在于同一种关系有大量不同的说法,「任教于」「在……工作」「是……的教师」都要归到同一个关系类型上。第 05 篇展开。
第四步是知识融合,把新抽出的三元组和已有图谱对齐。如果图谱里已经有「北京大学」这个实体,新抽出的就必须连到同一个节点上,而不是新建一个名字相同但孤立的节点。这一步还会处理冲突:两个来源对同一事实给出不同值时该采信哪个。第 07 篇展开。
第五步是入库与推理,此时图可以回答「谁在北京大学任职」,也可以沿着已有关系推出没有直接存储的结论。
这条链路上有一件事必须做到,否则图谱会变成一个难以排查的黑箱:每条结论都要能回溯到原始出处。 当系统给出一个错误答案时,需要能顺着链路查到这个错误是抽取错的、对齐错的,还是原始文本本身就有问题。所以三元组通常要带上来源和置信度,而不是只存关系本身。
四、五层结构里各层的职责
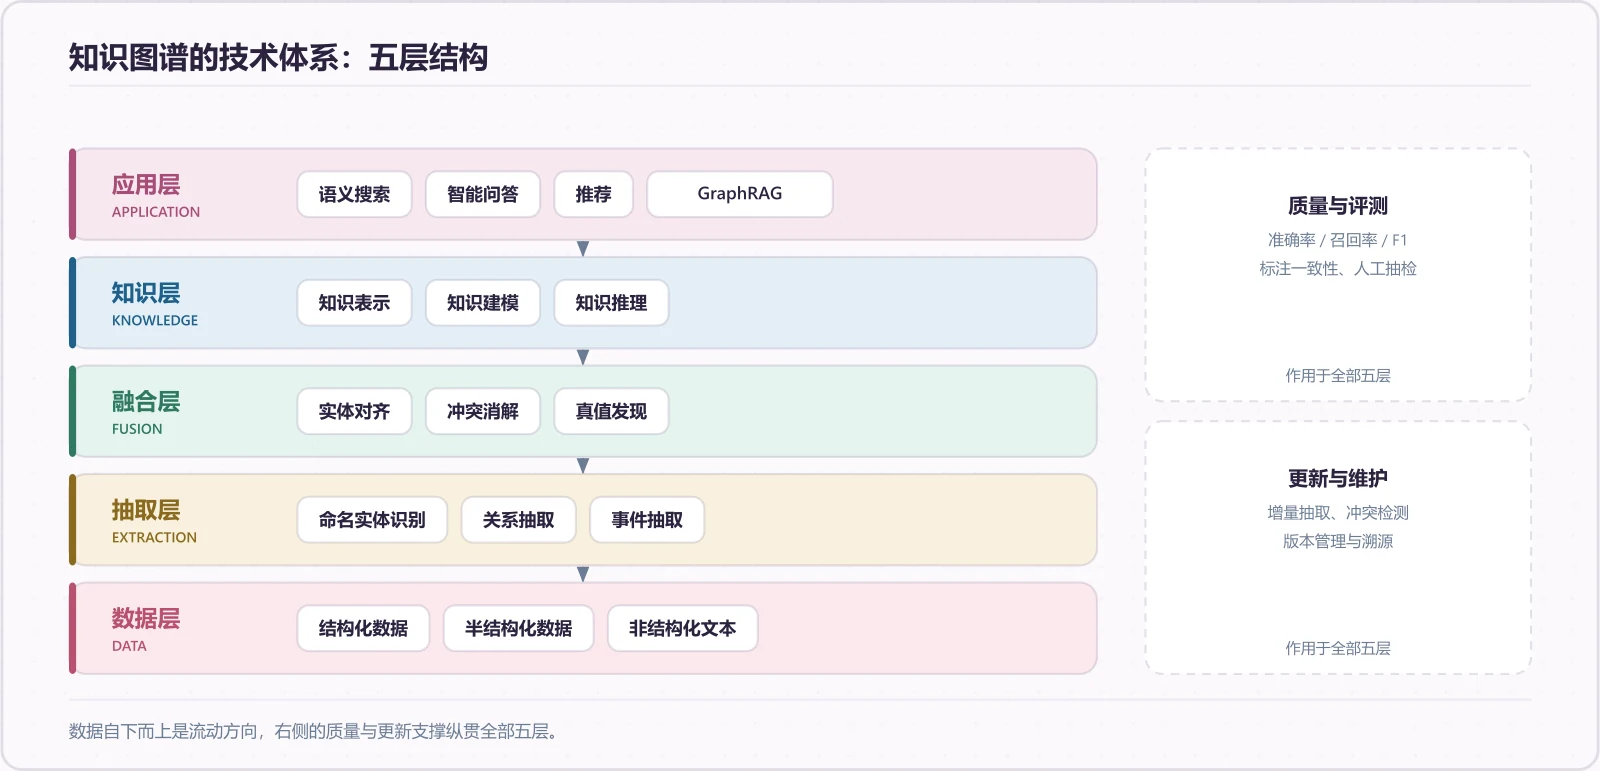
把上面的链路放大到完整体系,就是知识图谱的五层结构。纵向看是数据的流动方向,横向看是每层解决的问题。
| 层次 | 解决的问题 | 主要技术 | 对应文章 |
|---|---|---|---|
| 数据层 | 知识从哪里来 | 结构化数据库、网页、文档 | — |
| 抽取层 | 怎么从文本里取出实体和关系 | 命名实体识别、关系抽取、事件抽取 | 03–06 |
| 融合层 | 多来源的知识怎么合成一份 | 实体对齐、冲突消解、真值发现 | 07 |
| 知识层 | 知识怎么表示、怎么推理 | 知识表示、本体建模、推理 | 01–02、08 |
| 应用层 | 用图谱做什么 | 语义搜索、智能问答、GraphRAG | — |
这个分层不是学术上的严格划分,而是工程分工的反映:不同层的技术栈、评测指标和迭代节奏都不一样。抽取层的指标是准确率和召回率,融合层关心的是对齐准确率和冲突处理策略,知识层关注的是表达能力与推理代价的权衡。
五、两条贯穿全部五层的支撑
前面那张图右侧有两个虚线框,它们不属于任何单独一层,但作用于全部五层。
质量与评测。 知识图谱的错误有两类,处理方式完全不同。一类是抽取错误,比如把「张三」误标成机构,这类问题可以靠提高模型和增加标注数据来缓解。另一类是本体错误,比如 schema 里把「导师」定义成了对称关系,这类问题会让全图推出一批系统性错误结论,而且从单个三元组上看不出异常。第二类更危险,因为它不会在准确率指标上暴露出来。
更新与维护。 知识图谱不是建一次就完事的东西。现实世界在变,人物的任职会变动,机构的名称会更改,产品会下架。一个没有更新机制的图谱,价值会随时间衰减。更新带来的新问题是冲突检测:新抽出的三元组和已有的矛盾时,是覆盖、保留两条,还是标记为待人工确认。这需要在 schema 设计阶段就定好规则。
六、给初学者的阅读顺序
这九篇按技术分层组织,但不必按顺序读。按目标选择:
只想知道知识图谱能做什么、和已有的向量检索怎么配合:读本篇和第 08 篇。两篇加起来覆盖了选型判断需要的信息。
准备动手建一个图:先读第 02 篇定 schema。这一步最容易被跳过,也是最容易返工的。schema 定下来之后再改,已有的三元组可能全部需要重新对齐。然后是第 03 到 06 篇的抽取方法,最后读第 07 篇解决多来源合并的问题。
关心大模型方向:本篇、第 03 篇和第 08 篇的信息密度最高。第 08 篇讲知识图谱与大模型的双向关系,包括图谱如何抑制幻觉、以及大模型如何反过来辅助图谱构建。
只是想了解技术演进:第 01 篇从 1960 年代的语义网络讲到今天的向量表示,把每一代方法为什么被替换讲得比较细。
关于本系列的取材与边界
每篇文章里提到的方法论、模型名、数据集名和数字都来自公开资料。需要说明两点:
- 涉及描述逻辑的推理算法(例如 Tableau 如何展开、ALC 的语义表)时,本系列只讲到结论和取舍,没有展开算法细节。要看细节需要回到描述逻辑的教材或原始论文。
- 涉及具体工程参数(例如什么规模该建图、抽取模型选哪个)时,给出的都是常见做法的范围,不是可以直接照抄的配置。这类判断依赖具体数据,无法脱离场景给答案。